




Naar de inhoud

QA voor AI-agents

Je AI-agent beantwoordt klanten. Kaizo controleert elk antwoord.

Kaizo scoort 100% van de gesprekken van je AI-agents op je eigen scorecard, dezelfde waarop je team wordt gescoord, en koppelt elke score aan het bewijs in het gesprek. Houd het volledig geautomatiseerd, of voeg menselijke review toe precies waar het ertoe doet.

Live in dagen · Native apps voor Zendesk en Salesforce

QA voor AI-agents
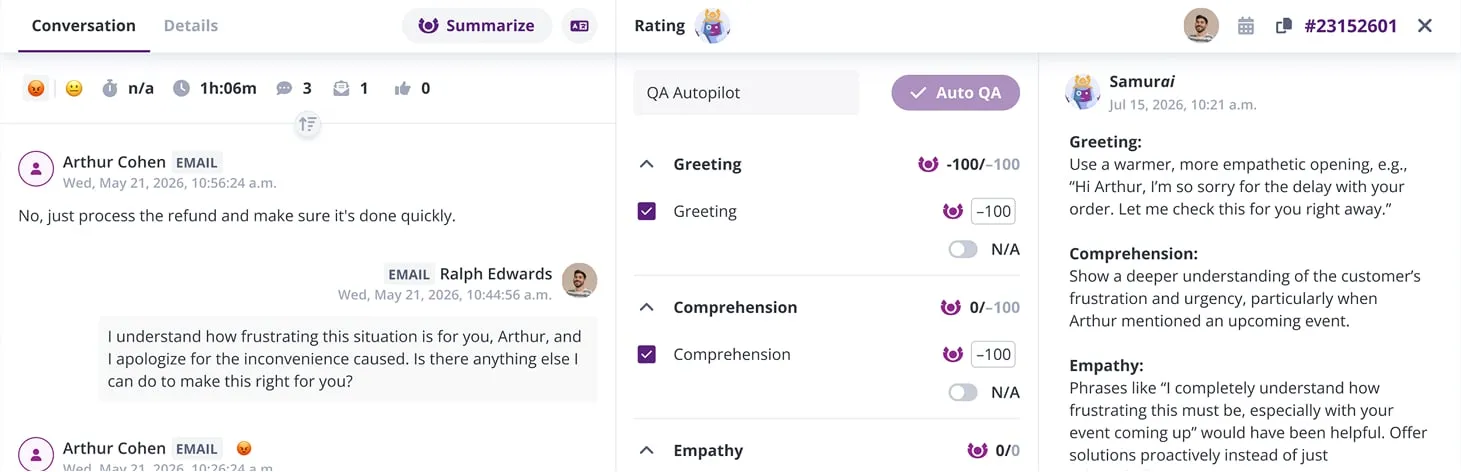
AutoPilot scoort een opgelost supportgesprek op een eigen scorecard

Vertrouwd door internationale supportteams

5/5 op G2
  • AICPA SOC 2-keurmerk SOC 2 Type II
  • ISO 27001-keurmerk ISO 27001
  • AVG-sterren (GDPR) GDPR
Trust Center

Een geautomatiseerde oplossing is geen kwaliteitsscore

Je helpdesk telt een gesprek als opgelost wanneer de klant geen mens heeft bereikt. Dat zegt niet of het antwoord klopte. Een AI-agent kan een beleid verzinnen, een probleem ten onrechte opgelost verklaren of een case houden die hij had moeten overdragen, en elk dashboard telt dat toch als een succes. Omdat hij elke keer vanuit dezelfde prompt en dezelfde content antwoordt, herhaalt dezelfde fout zich in elk gesprek dat hij raakt, en een steekproef van 2% mist hem meestal.

Hoe het werkt

Eén standaard voor menselijke en AI-agents

Kaizo draait in de helpdesk waar de gesprekken van je AI-agent al staan, en scoort ze zoals het de gesprekken van je team scoort.

Je scorecard

Dezelfde scorecard, met controles voor een bot.

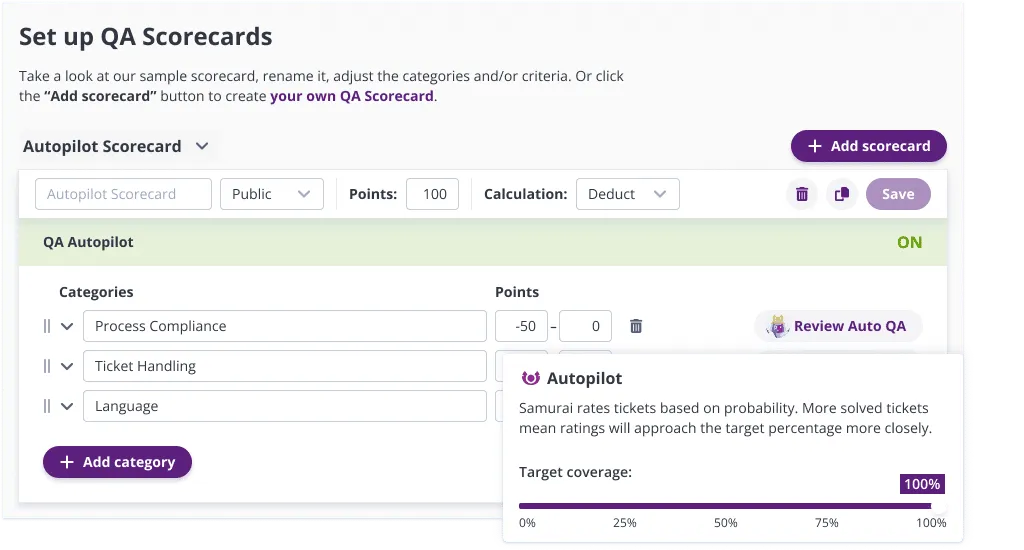
Scoor gesprekken van AI-agents op dezelfde scorecard als die van je team, zodat je menselijke en AI-agents naast elkaar ziet presteren. Voeg daarna de criteria toe waarop een bot faalt: feitelijke juistheid, trouw aan het beleid, afbakening en escalatie. Schrijf ze in je eigen woorden en koppel je kennisbank, zodat de AI beoordeelt op basis van jouw content.

  • Criteria in je eigen woorden, geen template
  • Gedeelde criteria houden menselijke en AI-resultaten vergelijkbaar
  • Extra controles op verzonnen feiten en verzonnen beleid
Zo werken scorecards
Je scorecard
Een Kaizo QA-scorecard met AutoPilot aan op 100% doeldekking

Elk gesprek

Elk gesprek van de AI-agent gescoord, met het bewijs.

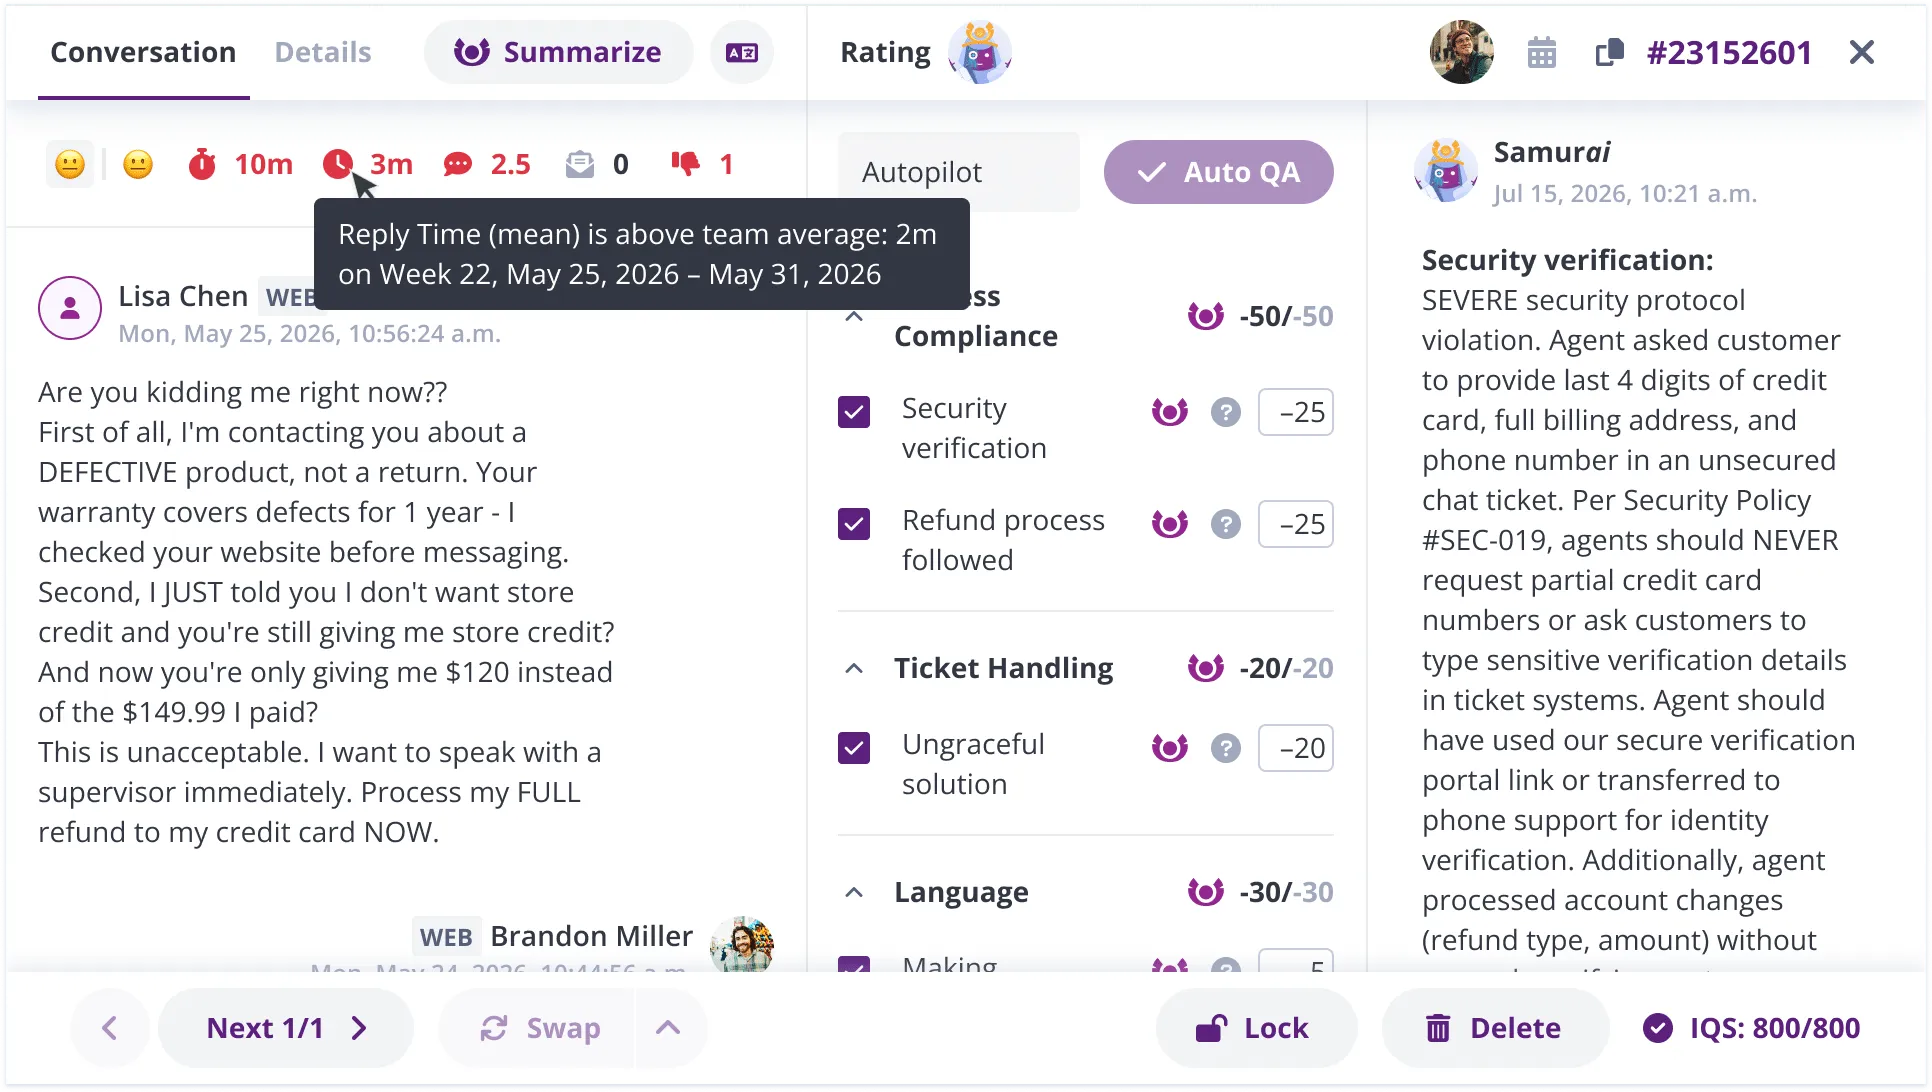
AutoPilot scoort elk gesprek zodra het is opgelost en voegt een opmerking toe die de score uitlegt. Elke score linkt naar het bewijs in het gesprek, zodat een fout een concreet voorbeeld wordt dat je kunt voorleggen aan wie de prompt of het helpcenterartikel beheert.

  • 100% van de gesprekken, geen steekproef
  • Elke score uitgelegd en gekoppeld aan de regels erachter
  • Jij kiest welke wachtrijen, kanalen of teams worden gescoord
Meer over AutoPilot
Elk gesprek
AutoPilot-scores op een supportgesprek, met de reden voor elk niet-gehaald criterium

Monitoring en analyse

Zie waar de AI-agent faalt, en waarom.

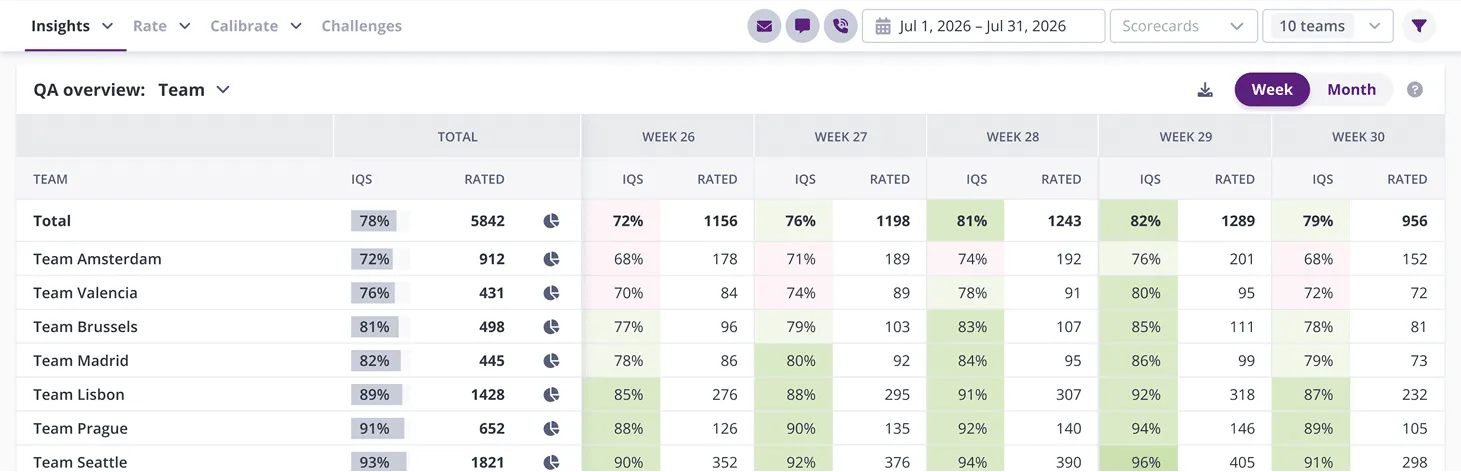
Als elk gesprek gescoord is, is een terugkerende fout geen anekdote meer maar een trend die je per team en per week volgt. Grondoorzaakanalyse groepeert de fouten achter een dip, zodat tien foute antwoorden uit één artikel één oplossing worden. Scoor na elke wijziging opnieuw om te bevestigen dat de oplossing standhoudt.

Meer over grondoorzaakanalyse
Monitoring en analyse
Kaizo QA-overzicht met kwaliteitsscores per team en per week

Menselijke review

Mensen blijven betrokken.

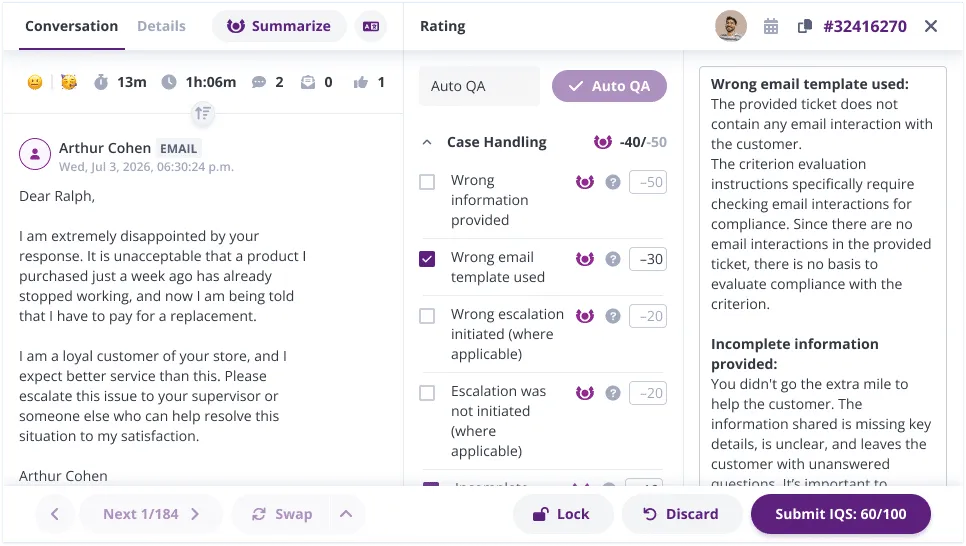
Test de scoring op je historische beoordelingen voordat hij live gaat, en stem de criteria af tot hij overeenkomt met je team. Reviewers houden de gesprekken die oordeelsvermogen vragen: Auto QA vult de criteria vooraf in en schrijft de feedback, die zij aanpassen en goedkeuren.

Meer over Auto QA
Menselijke review
Auto QA vult beoordelingscriteria vooraf in voor een menselijke reviewer
100%
van de QA geautomatiseerd bij UiPath
200%
ROI op QA-automatisering bij UiPath
75%
minder voorbereiding voor coaching bij EverHelp

Wanneer Kaizo niet de juiste tool is

Kaizo scoort gesprekken nadat ze zijn afgerond, in de helpdesk waar ze staan. Heb je vóór de lancering een testsuite voor developers nodig, zoals regressietests voor prompts in je CI-pipeline, dan is dat een andere fase en een ander soort tool, die naast Kaizo kan draaien. En als je AI-agent een paar dozijn gesprekken per week afhandelt, lees ze dan zelf: een uur per week met de transcripties en een korte checklist vinden de meeste problemen.

Nieuw in dit onderwerp? Lees onze gids over QA voor AI-agents, waarom de containment rate geen kwaliteitsscore is, welke metrics voor AI in de klantenservice je volgt (gidsen in het Engels), of bekijk de prijzen.

Test je een voice-agent?

Een voice-agent vóór de lancering testen met gescripte testgesprekken is testen vóór de lancering: een andere fase dan QA van echte gesprekken. Vertel ons over je setup, dan zeggen we je eerlijk of het past.

Supportteams die gestopt zijn met steekproeven

  • 50%

    minder tijd aan QA

    “Our tickets can be long and complex. AI has been a life-saver in our experience.”

    SteelSeries

  • 75%

    snellere oplossing

    “Kaizo is an essential part of finding the root causes of areas we need to improve, then improving on that.”

    Foot Locker

FAQ

Veelgestelde vragen

Wat is QA voor AI-agents?

QA voor AI-agents betekent dat je de gesprekken van je chatbot of AI-agent scoort op een geschreven standaard, zodat je weet of de antwoorden klopten en waren toegestaan, en niet alleen of de klant een mens bereikte. Kaizo doet dat bij elk gesprek, en elke score linkt naar het bewijs.

Kan Kaizo AI-agents van andere leveranciers scoren?

Ja. Als het gesprek in Zendesk of Salesforce staat, scoort Kaizo het op dezelfde scorecard als die van je team, wie de agent ook heeft gebouwd. In Zendesk horen daar de gesprekken bij die de AI-agents van Zendesk afhandelen.

Krijgt de AI-agent dezelfde scorecard als onze medewerkers?

Hij kan de criteria delen die voor beide gelden, zoals een juist antwoord en de juiste toon, zodat de resultaten vergelijkbaar blijven. Voeg daarna de criteria toe waarop een bot faalt: verankering in je eigen content, grenzen van het beleid, afbakening en escalatie.

Kan Kaizo de overdracht van de AI-agent naar een mens controleren?

Ja, als criteria op je scorecard: escaleerde de AI-agent bij de juiste trigger, gaf hij de context door, en pakte de medewerker het op? Je ziet de overdracht in hetzelfde gesprek waar de score naar linkt.

Betekent een hoge containment rate dat de AI-agent werkt?

Niet op zichzelf. Containment telt een gesprek als succes wanneer de klant geen mens bereikte, en een valse oplossing of een case die de agent had moeten overdragen ziet er precies zo uit. Je moet scoren wat de agent zei om te weten of een gecontained gesprek een goed gesprek was.

Wie controleert de scores?

Je team, overal waar het ertoe doet. Je test de scoring op je eerdere beoordelingen voordat hij live gaat, elke score linkt naar het bewijs zodat iedereen hem kan controleren, en Auto QA schrijft feedback die een reviewer aanpast en goedkeurt.

Moeten we van helpdesk veranderen?

Nee. Kaizo integreert native met Zendesk en Salesforce Service Cloud en leest de gesprekken daar rechtstreeks uit. De setup duurt dagen, geen connectorproject.

Verkoopt Kaizo ook AI-agents?

Ja. Het Kaizo Agentic Customer Service Platform brengt AI-agents met een vaste rol voor het werk achter supportkwaliteit. Het draait als pilot in Q4 2026, en het werk van de agents wordt gemeten aan dezelfde standaard als dat van je medewerkers. Het Quality Assurance Platform dat gesprekken van AI-agents scoort, is nu beschikbaar.

Zie het op de gesprekken van je AI-agent

We scoren een steekproef van je echte AI-agentgesprekken op jouw criteria en laten zien wat het dashboard als succes telde.

Vertrouwd door internationale supportteams

  • Foot Locker
  • SteelSeries
  • Canva
  • GetYourGuide
  • Instacart