
Una scheda di valutazione call center (la QA scorecard) è un elenco ponderato di criteri con cui un team di assistenza valuta ogni conversazione con i clienti, più alcune regole di errore bloccante per le mancanze che da sole fanno fallire una conversazione. Trasforma il “buon servizio” in voci che due revisori, o un’AI, valutano allo stesso modo, e il totale diventa il punteggio qualità su cui si basano coaching e report. Qui sotto trova un modello da copiare che valuta con una sola scheda le conversazioni degli operatori e degli agenti AI, più la matematica di pesi, N/A e campione che quasi tutte le guide omettono.
In sintesi
- Una scheda di valutazione ha cinque parti: criteri, pesi, una scala, regole di errore bloccante e la registrazione delle evidenze dietro ogni punteggio.
- Le schede pubblicate pesano le stesse sezioni in modo molto diverso: ricavi i suoi pesi dalle sue escalation e verifichi che prevedano il CSAT.
- Quando un criterio non si applica, tolga i suoi punti dal denominatore: valutarlo zero può spostare un risultato di 17 punti.
- Con cinque valutazioni per operatore il margine di errore su un tasso di superamento è di circa 26 punti: basta per il coaching, non per stilare classifiche.
- Quando persone e agenti AI condividono la stessa coda, una scheda con criteri comuni, voci per un solo tipo di agente ed errori bloccanti per ciascuno tiene entrambi sullo stesso standard.
Che cos’è una scheda di valutazione QA?
Una scheda di valutazione QA (QA scorecard) è un elenco strutturato di criteri ponderati usato per valutare la qualità di una conversazione di assistenza clienti. Ogni criterio descrive una parte di ciò che rende buona un’interazione, e ogni conversazione viene valutata rispetto a questi criteri per ottenere un punteggio qualità complessivo che guida il coaching e il report.
Pensi alla scheda come alla definizione di qualità resa concreta. Invece di una vaga impressione che una conversazione sia andata “bene”, la scheda scompone la qualità in elementi specifici e misurabili (il problema è stato risolto? il tono era giusto? la procedura è stata rispettata?) e assegna a ciascuno un peso. È ciò che rende il QA coerente, utile per il coaching e difendibile.
La scheda è lo strumento intero: criteri, pesi, scala ed errori bloccanti. Le istruzioni dettagliate su cosa vale ogni livello di punteggio si chiamano di solito rubrica QA, e una buona scheda le riporta per ogni criterio, così revisori e AI leggono ogni voce allo stesso modo.
Perché la scheda di valutazione è importante
È sulla scheda che la maggior parte dei programmi di QA riesce o fallisce. Una buona scheda:
- Crea coerenza, perché ogni revisore, e ogni valutazione dell’AI, applichi lo stesso standard.
- Rende il feedback specifico, perché gli operatori sappiano esattamente cosa migliorare, non solo il punteggio complessivo.
- Allinea la qualità ai risultati, valutando i comportamenti che incidono davvero sul CSAT e sulla risoluzione.
- Regge alle verifiche, quando un operatore contesta un punteggio o un’autorità di vigilanza chiede prove.
Una scheda sovraccarica o vaga ottiene l’effetto opposto: trasforma il QA in un esercizio soggettivo di caselle da spuntare di cui gli operatori non si fidano e su cui i manager non possono agire.
Cosa include una buona scheda di valutazione QA
Ogni scheda efficace ha alcuni ingredienti comuni:
- Criteri chiari, scritti come domande oggettive a cui si può rispondere.
- Pesi che riflettono quanto conta ciascun criterio per la sua azienda.
- Una scala di valutazione, spesso sì/no, oppure da 1 a 5 per i criteri più sfumati.
- Regole di errore bloccante per i comportamenti critici ai fini della conformità.
- Sezioni o categorie che raggruppano i criteri correlati per un report leggibile.
Categorie e criteri della scheda di valutazione QA
La maggior parte delle schede di valutazione per l’assistenza clienti organizza i criteri in quattro categorie:
| Categoria | Esempi di criteri |
|---|---|
| Risoluzione | Il problema è stato risolto del tutto? L’informazione era corretta? È stata proposta la soluzione giusta? |
| Conformità | Il cliente è stato verificato? Sono state date le informative obbligatorie? La procedura è stata rispettata? |
| Comunicazione | Il tono era empatico e professionale? La risposta era chiara? La preoccupazione del cliente è stata riconosciuta? |
| Efficienza | Il problema è stato gestito senza trasferimenti, ripetizioni o ritardi inutili? |
Esempi di scheda di valutazione QA per canale
Una scheda dovrebbe adattarsi al canale. Ecco alcuni esempi semplificati.
Scheda di valutazione per chat / messaggistica
| Criterio | Peso |
|---|---|
| Problema risolto con precisione | 30% |
| Tempi di risposta e ritmo adeguati | 15% |
| Messaggi chiari, ben formattati ed empatici | 25% |
| Processo e verifica corretti rispettati | 20% |
| Chiusura corretta e prossimi passi | 10% |
Scheda di valutazione per email / ticket
| Criterio | Peso |
|---|---|
| Risoluzione completa e corretta nel minor numero di risposte | 35% |
| Tono professionale, coerente con il brand, e grammatica | 25% |
| Conformità e procedure rispettate | 25% |
| Struttura chiara e prossimi passi | 15% |
Scheda di valutazione per voce / chiamate
| Criterio | Peso |
|---|---|
| Problema risolto, informazioni corrette | 30% |
| Verifica dell’identità e conformità | 25% |
| Empatia, ascolto attivo, tono | 25% |
| Gestione della chiamata ed efficienza | 20% |
Come costruire una scheda di valutazione QA
- Parta dalla sua definizione di qualità. Elenchi com’è una conversazione eccellente per il suo team, poi raggruppi questi elementi in categorie.
- Scriva criteri oggettivi. Formuli ciascuno come una domanda chiara a cui un revisore o l’AI possa rispondere in modo coerente. Eviti termini vaghi come “buon servizio”.
- Assegni i pesi. Dia più peso a ciò che incide sui risultati per il cliente. Di solito risoluzione e conformità pesano di più.
- Definisca le regole di errore bloccante. Decida quali mancanze fanno fallire l’intera conversazione, a prescindere dal resto.
- Faccia un pilota e calibri. Valuti un lotto di conversazioni con il suo team, confronti i risultati e affini la formulazione finché la valutazione non è coerente.
- Riveda la scheda con regolarità. La aggiorni man mano che cambiano prodotti, procedure ed esigenze dei clienti.
Modello gratuito di scheda di valutazione QA
Il modello della sezione successiva è quello da copiare se persone e agenti AI rispondono nelle stesse code. Se le serve solo una scheda per un canale (chat, email, voce o reclami), parta dai nostri cinque modelli pronti per canale (in inglese) e adatti i pesi.
Modello di scheda di valutazione per operatori e agenti AI
Una scheda di valutazione per operatori e agenti AI è un’unica scheda in tre parti: criteri comuni che valutano ogni conversazione allo stesso modo, alcune voci che valgono solo per l’agente AI o solo per le persone, e regole di errore bloccante per ciascuno. Ogni voce valutata registra la sua evidenza, così chiunque può verificare perché è stata superata o no.
Copi la tabella in un foglio di calcolo o nel suo strumento di QA. I punti sono un esempio: li adatti alle sue escalation, come spiegato più avanti nella parte sulla ponderazione. Ogni voce vale tutti i punti o zero, e si segna N/A quando non si applica.
| # | Criterio | Si applica a | Superato se | Punti | Evidenza da registrare |
|---|---|---|---|---|---|
| 1 | Risposta corretta | Entrambi | Ogni informazione è giusta per il caso di questo cliente | 20 | La riga con l’informazione e l’articolo o la policy con cui deve coincidere |
| 2 | Risposta completa | Entrambi | Ogni parte della domanda ha risposta, condizioni comprese | 10 | La parte della domanda rimasta senza risposta |
| 3 | Policy rispettata | Entrambi | Nulla viene offerto, promesso o rifiutato fuori dalla policy scritta | 15 | L’offerta o il rifiuto, con la policy e la versione violate |
| 4 | Prossimo passo chiaro | Entrambi | Il cliente sa cosa succede ora, oppure il problema è risolto | 10 | Il messaggio di chiusura |
| 5 | Tono adatto alla situazione | Entrambi | La risposta è in linea con il brand e con lo stato del cliente | 5 | La riga che non va, citata |
| 6 | Passaggio di consegne | Entrambi, N/A senza trasferimento | Il contesto passa con il trasferimento e chi riceve lo usa | 10 | La nota di passaggio e la prima risposta di chi riceve |
| 7 | Basata sui suoi contenuti | Solo agente AI | Ogni informazione viene da un articolo o da una policy che pubblica | 5 | L’articolo usato, oppure “nessuna fonte trovata” |
| 8 | Resta nel perimetro | Solo agente AI | Gestisce solo gli argomenti e le azioni che le sono consentiti | 5 | La richiesta fuori perimetro e la risposta |
| 9 | Passa la mano o ammette di non sapere | Solo agente AI | Trasferisce sui trigger definiti e non tira a indovinare | 5 | La riga del trigger e cosa ha fatto poi l’agente AI |
| 10 | Note e tag del caso | Solo operatore | Chi viene dopo può continuare senza richiedere nulla al cliente | 8 | La nota o il tag mancante |
| 11 | Follow-up mantenuto | Solo operatore, N/A senza promessa | Il richiamo o l’aggiornamento promesso è avvenuto nei tempi | 7 | La promessa e la data in cui è stata mantenuta o mancata |
La scheda vale 100 punti in tutto: 70 comuni, 15 per l’agente AI e 15 per le persone. In ogni conversazione le voci dell’altro tipo di agente sono N/A, quindi una conversazione può ottenere al massimo 85 punti, o 75 senza trasferimento. Divida per i punti disponibili, esattamente come nella regola del N/A più avanti, e ogni conversazione avrà comunque una sola percentuale.
Confronti persone e agenti AI solo sulle voci comuni, argomento per argomento, perché all’agente AI arrivano di solito gli argomenti più semplici. La nostra guida alla scheda di valutazione unica per operatori e agenti AI mostra questo confronto con un esempio di calcolo, e l’alternativa di tenere le voci dedicate come superato o non superato accanto al punteggio invece che in punti. Per capire perché esistono le voci solo AI, e quali criteri pensati per le persone togliere a un bot, legga la guida alla scorecard per agenti AI.
Errori bloccanti per operatori e agenti AI
Gli errori bloccanti prevalgono sul punteggio, chiunque abbia risposto. Ne tenga al massimo cinque, renda ciascuno verificabile nella trascrizione e li riporti accanto al punteggio, non dentro.
| Errore bloccante | Si applica a | Come verificarlo |
|---|---|---|
| Dati dell’account condivisi prima di verificare l’identità | Entrambi | Manca il passaggio di verifica prima del primo dato dell’account |
| Rimborso, credito o eccezione promessi fuori policy | Entrambi | La promessa citata e confrontata con la policy scritta |
| Numeri di carta o password chiesti o ripetuti nella conversazione | Entrambi | La riga con il dato |
| Un trigger di passaggio obbligatorio ignorato, come la richiesta di parlare con una persona o una minaccia legale | Agente AI | La riga del trigger e le risposte successive |
| Linguaggio offensivo o discriminatorio verso il cliente | Entrambi | La riga citata |
La riga dell’agente AI è quella che le schede per le persone non hanno. Un operatore a cui chiedono un responsabile sa che deve trasferire; un agente AI deve esserne istruito, e quando le sue istruzioni non prevedono un trigger tiene il cliente in un circolo vizioso in ogni conversazione che lo incontra.
Come registrare le evidenze
Ogni voce valutata ha bisogno di una traccia che un’altra persona possa verificare senza rileggere l’intera conversazione. Registri cinque cose per voce: il link alla conversazione, la riga o le righe citate, l’articolo o la policy usati per il controllo, la versione della scheda e chi ha valutato, un revisore o un sistema automatico.
L’evidenza decide chi deve intervenire. Una voce non superata nella conversazione di un operatore va al coaching. Una voce non superata nella conversazione di un agente AI va a chi gestisce il prompt, l’articolo del centro assistenza o l’impostazione che ha usato, mai alla persona che ha poi preso in carico la conversazione. Nelle schede di valutazione di Kaizo, AutoPilot valuta ogni conversazione quando viene risolta, aggiunge un commento che spiega il punteggio e collega ogni punteggio alle evidenze nella conversazione.
Esempio di calcolo: una conversazione di un operatore e una di un agente AI
Due conversazioni della stessa coda di fatturazione, valutate con la scheda qui sopra. I dettagli sono inventati per mostrare il calcolo, non sono dati di un cliente.
| Criterio | Conversazione A: operatore, cambio piano, nessun trasferimento | Conversazione B: agente AI, richiesta di rimborso, trasferita a una persona |
|---|---|---|
| 1 Risposta corretta (20) | 20: nuovo prezzo e data di inizio coincidono con il listino | 0: “Può restituirlo entro 30 giorni con rimborso completo.” La policy rimborsi v3 prevede 14 giorni per i prodotti aperti |
| 2 Risposta completa (10) | 10 | 10 |
| 3 Policy rispettata (15) | 15 | 0: rimborso completo promesso su un prodotto aperto |
| 4 Prossimo passo chiaro (10) | 0: chiude con “Verifico e le faccio sapere”, senza tempi né canale | 10: dice al cliente che un collega prenderà in carico la chat |
| 5 Tono adatto alla situazione (5) | 5 | 5 |
| 6 Passaggio di consegne (10) | N/A | 0: passa il numero d’ordine, ma la nota non menziona la promessa di rimborso |
| Voci 7 a 9 solo agente AI (15) | N/A | 10: nel perimetro e trasferita su richiesta (10); base nei contenuti non superata (0), nessun articolo parla di 30 giorni |
| 10 Note e tag del caso (8) | 0: nessuna nota sul cambio piano | N/A |
| 11 Follow-up mantenuto (7) | 7: email di conferma inviata in giornata | N/A |
| Punti ottenuti / disponibili | 57 / 75 | 35 / 85 |
| Punteggio | 76% | 41% |
| Errore bloccante | Nessuno | Rimborso promesso fuori policy |
| A chi va | Coaching su prossimi passi e note del caso | A chi gestisce l’articolo sui rimborsi e le istruzioni di rimborso dell’agente AI |
La conversazione B viene riportata con un 41% e il segnale di errore bloccante, non fusa in un unico zero. La persona che l’ha presa in carico viene valutata sulla propria gestione della promessa ritirata, nella propria conversazione, così l’errore dell’agente AI non finisce mai sul suo punteggio. Sulle sole voci comuni A ottiene 50 su 60 e B 25 su 70: sono questi i numeri da usare quando confronta i due tipi di agente per argomento.
Ponderazione e punteggio qualità della scheda di valutazione
È la ponderazione che trasforma una checklist (in inglese) in un punteggio significativo. Alcuni principi:
- Ponderi in base all’impatto. I criteri che incidono su risoluzione e conformità devono pesare più di quelli estetici.
- Mantenga la scala semplice. Il sì/no è facile da applicare in modo coerente; usi una scala da 1 a 5 solo dove la sfumatura conta davvero.
- Normalizzi a 100. Una percentuale complessiva è facile da seguire nel tempo e da confrontare tra team.
- Eviti di dare troppo peso alla soggettività. Più un criterio dipende dall’opinione del revisore, più calibrazione richiede.
Le schede pubblicate non sono d’accordo, ed è proprio questo il punto
Non esiste una ponderazione standard di settore, e i fornitori che pubblicano la propria non sono d’accordo tra loro. Balto pondera per sezione: saluto 10%, comunicazione 25%, conformità 20%, risoluzione 25%, chiusura 20%. VereQuest pubblica una scheda di comportamenti da 100 punti che assegna 20 alla risoluzione dei problemi, 15 all’empatia e 15 alla presa in carico (ownership), con il saluto a 5 e l’uso del nome del cliente a 2. Five9 pondera i risultati invece dei comportamenti: CSAT 30%, FCR 25%, punteggio QA 20%, AHT 15%, aderenza 10%.
Balto assegna trenta punti su cento al modo in cui la conversazione si apre e si chiude. Le nostre schede per canale qui sopra non gli danno quasi nulla. Nessuna delle due è sbagliata. I pesi sono una decisione di business, non una best practice da copiare, quindi ricavi i suoi:
- Parta da ciò che va storto davvero. Prenda le sue ultime 50 escalation, rimborsi e reclami e associ a ciascuno il comportamento che lo avrebbe evitato. Se 30 di questi derivano da informazioni sbagliate date con sicurezza, la precisione merita più di 5 punti.
- Verifichi che i pesi prevedano qualcosa. Valuti 100 conversazioni, poi metta in correlazione i punteggi di ogni sezione con il CSAT o con l’esito di risoluzione di quelle stesse conversazioni. Se il suo punteggio sul tono non ha alcun legame con la soddisfazione finale del cliente, non dovrebbe valere 20 punti. È mezza giornata di lavoro su un foglio di calcolo e quasi nessuno lo fa.
La trappola del N/A che rompe in silenzio la maggior parte delle schede
Se un criterio non si applica a una conversazione, tolga i suoi punti dal denominatore. Non lo valuti zero e non lo lasci lì in silenzio.
L’aritmetica conta più di quanto sembri. Un operatore ottiene 68 punti su una scheda in cui un criterio da 20 punti non era davvero applicabile. Dividendo per il totale ridotto si ottiene 68 su 80, cioè 85%. Dividendo per i 100 originali si ottiene 68%. Uno scarto di 17 punti prodotto interamente da una scelta contabile.
VereQuest gestisce il caso in modo esplicito, osservando che quando si usa il N/A “the total % or total # of points is reduced by that amount” (la % totale o il numero totale di punti si riduce di quella quantità). Verifichi cosa fa il suo strumento per impostazione predefinita, perché non tutti lo gestiscono correttamente. Se vuole la forma generale, l’internal quality score di Zendesk è la somma delle valutazioni divisa per il punteggio massimo disponibile nelle varie categorie. La parola importante è disponibile, non possibile.
Criteri di errore bloccante
Alcune mancanze sono abbastanza gravi da far fallire la conversazione nonostante un punteggio altrimenti buono. Gli errori bloccanti tipici includono una verifica dell’identità saltata, un’informativa legale omessa, la comunicazione di informazioni regolamentate errate o una grave violazione della fiducia del cliente. Definire gli errori bloccanti in modo esplicito mantiene onesta la scheda: una conversazione che spunta ogni casella della comunicazione ma viola la conformità non è una buona conversazione, e il punteggio deve dirlo.
MaestroQA individua tre categorie legittime: violazioni di conformità e sicurezza, come esporre i dati di una carta o saltare la verifica; fornire consapevolmente informazioni sbagliate; e comportamenti offensivi. Tre regole rendono sostenibili gli errori bloccanti:
- Limiti l’elenco a cinque. Se tutto è critico, niente lo è.
- Ogni errore bloccante deve essere verificabile in modo oggettivo. Nessuno deve dipendere dal giudizio del revisore sul tono. Il tono si valuta; non deve mai essere un errore bloccante.
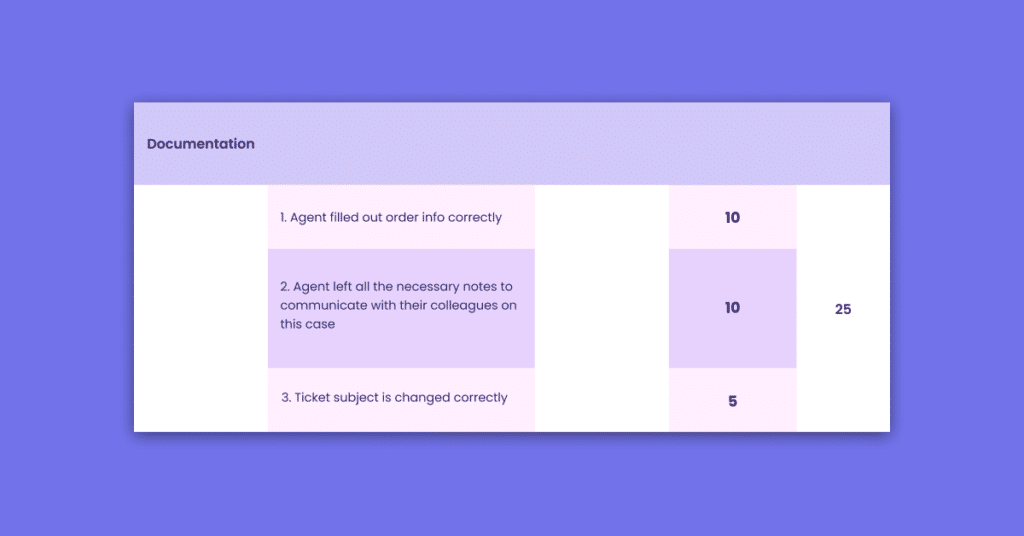
- Riporti gli errori bloccanti separatamente dal punteggio. Un operatore con un errore bloccante e diciannove conversazioni solide è un problema diverso da un operatore con una media del 60%. Fonderli in un’unica media mobile li nasconde entrambi, e un solo zero in un mese da cinque conversazioni fa scendere la media di 20 punti da solo.
Qual è un buon punteggio QA?
Non esiste una soglia di sufficienza universale, perché dipende da quanto è esigente la sua scheda. La maggior parte dei programmi maturi fissa una fascia obiettivo, spesso intorno all’85-90% e oltre, e considera i punteggi inferiori un segnale per il coaching. Due cose contano più del numero principale: i criteri di errore bloccante, che lo sovrastano, e l’andamento per operatore e per team nel tempo, soprattutto se è correlato al CSAT. Un singolo punteggio dice poco; un andamento in crescita che accompagna clienti più soddisfatti dice tutto.
C’è una ragione più solida per non fissarsi sul numero principale, ed è aritmetica, non filosofica.
Quante conversazioni dovrebbe valutare?
Valuti da 5 a 10 conversazioni per operatore al mese se l’obiettivo è il coaching, e tratti il risultato come un’indicazione, non come una classifica. Con cinque valutazioni il margine di errore sul tasso di superamento di un operatore è di circa 26 punti al 95% di confidenza: per stilare classifiche o legarci la retribuzione servono campioni molto più grandi, oppure valutare ogni conversazione.
Le indicazioni pubblicate variano di oltre dieci volte, e nessuna si concilia con le altre.
Call Centre Helper consiglia 5-6 chiamate per operatore, e Garry Gormley di FAB Solutions lo definisce il punto di equilibrio tra equità e costo delle risorse. HiveDesk consiglia 5-10 per operatore al mese, che salgono a 10-15 per i nuovi assunti nei primi 90 giorni. OttoQA sostiene circa 65 per operatore al mese, anche se si tratta di un argomento di un fornitore basato su ipotesi di volume aggressive e senza alcuna fonte. C2Perform indica i parametri statistici giusti, 95% di confidenza e 5% di margine di errore con Z = 1,96, ma non riporta mai la formula.
Ecco quindi il calcolo. Consideri ogni conversazione valutata come superata o non superata rispetto al suo standard di qualità. Il margine di errore sul tasso di superamento reale di un operatore, con il 95% di confidenza, ipotizzando che quel tasso sia davvero del 90%:
| Conversazioni valutate per operatore | Margine di errore |
|---|---|
| 5 | più o meno 26,3 punti |
| 10 | più o meno 18,6 punti |
| 25 | più o meno 11,8 punti |
| 50 | più o meno 8,3 punti |
| 100 | più o meno 5,9 punti |
Queste cifre sono calcolate, non tratte da una fonte: 1,96 moltiplicato per la radice quadrata di p(1-p)/n. Trattare il totale di una scheda come un tasso di superamento binomiale è una semplificazione, e voluta.
Un operatore valutato cinque volte che ottiene l’85% ha un tasso di qualità reale compreso grosso modo tra il 59% e il 100%. Non è possibile distinguerlo da un collega che ha ottenuto il 95%. Per restringere il margine a più o meno 5 punti servirebbero circa 139 valutazioni per operatore al mese.
Cosa farne, onestamente:
- Non stili classifiche tra operatori su campioni piccoli e non leghi la retribuzione a una media di cinque conversazioni. La misura non lo regge.
- Usi i campioni piccoli per il coaching. Cinque valutazioni non le diranno che un operatore è nell’ultimo decile, ma le mostreranno che questo operatore salta la verifica. Trovare un comportamento specifico e correggibile richiede molti meno dati che stilare una classifica delle persone.
- Aggreghi verso l’alto. Cinque valutazioni per operatore in un team di 40 persone fanno 200 dati a livello di team, più che sufficienti per individuare un problema di processo o di procedura.
- Aumenti il campione dove la posta in gioco è alta: nuovi assunti, conversazioni regolamentate e chiunque abbia una prestazione formalmente in discussione.
Valutare automaticamente ogni conversazione elimina questo problema, perché non resta alcun campione che possa essere poco rappresentativo. Introduce però rischi diversi, trattati più avanti.
Calibrazione: mantenere equi i punteggi
La calibrazione è ciò che rende affidabile una scheda. In una sessione di calibrazione, più revisori, e sempre più spesso l’AI, valutano le stesse conversazioni in modo indipendente, poi confrontano e riconciliano le differenze. Così emergono i criteri ambigui, si allinea l’interpretazione e si costruisce lo standard condiviso che porta gli operatori ad accettare i propri punteggi. Senza calibrazione, un “punteggio” è solo l’opinione di una persona. Con la calibrazione, la scheda diventa una misura equa e coerente, che è esattamente lo scopo.
La maggior parte delle indicazioni si ferma qui, senza dire come si riconosce una calibrazione riuscita. Le dia dei numeri. Ogni mese, da tre a cinque revisori valutano in modo indipendente le stesse sei conversazioni, senza discuterne, poi misurano due cose.
Dispersione dei punteggi. Lo scarto tra il totale più alto e quello più basso sulla stessa conversazione. Una soglia di lavoro pratica è 10 punti su una scheda da 100 punti. Uno scarto più ampio significa che le definizioni dei criteri sono ambigue, non che un revisore sbaglia.
Accordo per criterio. Individui su quali criteri specifici i suoi revisori non sono d’accordo. Quasi mai sono quelli binari. Sono le scale di giudizio con punti non definiti. Se vuole una misura formale, il kappa di Cohen corregge l’accordo per il caso, e le fasce standard di Landis e Koch collocano da 0,41 a 0,60 l’accordo moderato, da 0,61 a 0,80 quello sostanziale e da 0,81 a 1,00 quello quasi perfetto (qui una sintesi). Punti a 0,61 o più su ogni criterio con un peso reale. Sotto 0,41, il criterio misura il revisore e non l’operatore.
Corregga la scheda, non il revisore. Quando la calibrazione rileva un disaccordo, riscriva la definizione del criterio. Chiedere ai revisori di impegnarsi di più non sopravvive alla prossima conversazione ambigua.
Come la vivono gli operatori
Le schede sono progettate dai manager e vissute dagli operatori, e la distanza tra questi due punti di vista è dove i programmi di qualità falliscono in silenzio. Gli operatori dell’assistenza parlano dei loro programmi pubblicamente e nel dettaglio, e gli stessi schemi si ripetono.
Il campionamento sembra fortuna, perché con questi campioni in parte lo è. Un operatore racconta di andare bene sui tipi di conversazione in cui è più forte, e poi: “I followed my call flow to perfection on my new bookings and yet, they didn’t pull those.” (traduzione: “Ho seguito alla perfezione il mio flusso di chiamata sulle nuove prenotazioni, eppure non hanno preso quelle.”) (r/callcentres) Non è paranoia. È un margine di errore di circa 26 punti vissuto dall’interno.
Campioni diversi distruggono il confronto. Da una discussione sul QA automatizzato: “This means my score might be based on 20 calls and my coworkers is based on 34.” (“Significa che il mio punteggio potrebbe basarsi su 20 chiamate e quello del mio collega su 34.”) (r/callcentres) Se stila classifiche tra operatori, mantenga costante la dimensione del campione.
Un singolo evento incontrollabile può rovinare una media mobile. “My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100.” (“Il mio cane ha abbaiato (lo fa raramente) e ho preso zero su una chiamata che altrimenti sarebbe stata un 100 perfetto.”) (r/callcentres) È il problema della media con gli errori bloccanti, nella realtà.
I criteri che ignorano il motivo del contatto sembrano lavoro inutile. Un operatore, a proposito della valutazione sulla costruzione del rapporto: “I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment.” (“Lavoro per un fornitore di energia, non ho bisogno di accompagnare qualcuno in un percorso quando chiede di fare un pagamento.”) Se la sua scheda applica gli stessi criteri al reset di una password e alla comunicazione di un lutto, verrà vissuta con fastidio e misurerà la cosa sbagliata. Usi schede specifiche per canale o per tipo di contatto, oppure usi correttamente il N/A.
Gli errori dei revisori senza un modo per correggerli avvelenano l’intero programma. “3 of the 4 things that they said I didn’t ask, I absolutely did.” (“Di 4 cose che secondo loro non ho chiesto, 3 le ho chieste eccome.”) (r/callcentres)
La soluzione compare nella stessa discussione, descritta da un analista QA il cui programma funziona. Si inviano le chiamate a vicenda “to make sure we’re being fair and accurate” (“per essere sicuri di essere equi e precisi”), gli operatori possono contestare qualsiasi punteggio e, quando il team QA sbaglia, “own up to it and award the points back” (“lo ammettono e restituiscono i punti”). È calibrazione più un processo di ricorso, ed è la differenza tra una scheda di cui le persone si fidano e una che si limitano a sopportare.
Quindi preveda il ricorso fin dall’inizio. Dia agli operatori la conversazione valutata, il dettaglio per criterio, una scadenza per contestare e una persona designata che decide. Tenga traccia del tasso di punteggi ribaltati. Se è vicino a zero, probabilmente gli operatori hanno smesso di provarci. Se supera circa il 10%, la sua scheda è ambigua.
Errori comuni nella scheda di valutazione QA
- Troppi criteri. Una scheda sovraccarica diluisce il segnale che conta e rallenta la valutazione.
- Formulazione vaga. Criteri soggettivi producono punteggi incoerenti e resistenze da parte degli operatori.
- Nessuna ponderazione. Trattare tutti i criteri allo stesso modo nasconde ciò che conta davvero.
- Nessun errore bloccante. Lasciar passare una violazione di conformità perché il resto ha ottenuto un buon punteggio.
- Configurare e dimenticare. Una scheda mai aggiornata si disallinea dal business.
Valutazione manuale o automatica della scheda
Una scheda è utile solo quanto la sua capacità di applicarla. Con la valutazione manuale, anche un’ottima scheda raggiunge solo un campione, spesso da 5 a 10 conversazioni per operatore al mese. Con la valutazione AI, come con le schede di valutazione di Kaizo, la stessa scheda viene applicata a ogni conversazione, di persone o di AI, in modo coerente, liberando i revisori per la calibrazione e il coaching.
| Valutazione manuale | Valutazione automatica | |
|---|---|---|
| Copertura | Un campione per operatore | 100% delle conversazioni |
| Coerenza | Varia per revisore e per giorno | Un unico standard coerente |
| Impegno | Ore di valutazione ogni settimana | Reindirizzato al coaching |
Scopra come il controllo qualità automatico applica la sua scheda a ogni conversazione, e come l’AI Coaching trasforma i risultati nello sviluppo degli operatori.
Due team mostrano come funziona. In UiPath, Kaizo ha automatizzato il 100% del QA, con un ROI del 200% e un aumento dell’8% del punteggio qualità. SteelSeries ha dimezzato il tempo dedicato al QA, grazie ai riepiloghi AI su ticket lunghi e tecnici.
Una sola scheda per entrambi. Kaizo valuta ogni conversazione di assistenza, di persone o di AI, con la sua scheda di valutazione e collega ogni punteggio alle evidenze. Prenoti una demo.
Quando questa scheda non fa per lei
Una scheda completa, ponderata e con le evidenze su ogni voce è più di quanto serva ad alcuni team. Se gestisce qualche decina di conversazioni a settimana, le legga lei stesso con una breve checklist: la scheda ripaga quando non riesce più a leggere tutto. Se non ha ancora un agente AI, tolga le voci da 7 a 9 e l’errore bloccante dell’agente AI, e il modello funziona come una normale scheda per operatori. Se policy e articoli di assistenza non sono scritti, li scriva prima: “risposta corretta” e “policy rispettata” non si possono valutare rispetto a uno standard che esiste solo nella testa delle persone. E se le serve una batteria di test per un agente AI prima del lancio, come i test di regressione dei prompt, quella è un’altra fase e un altro tipo di strumento rispetto alla valutazione delle conversazioni concluse.
Gestire le versioni della scheda
La sua scheda cambierà e, quando succede, la continuità della sua serie storica si interrompe. I punteggi di prima e di dopo non sono confrontabili, e quasi nessuno lo segnala.
Bastano tre pratiche. Dia un numero di versione alla scheda e registri su ogni valutazione la versione usata. Non cambi mai i pesi a metà trimestre. Quando la modifica, rivaluti 20 conversazioni archiviate sia con la vecchia sia con la nuova scheda per conoscere l’entità dello scarto, poi annoti la modifica su ogni grafico che la attraversa.
Riveda la scheda due volte l’anno rispetto ai motivi di escalation attuali. I criteri che avevano senso due prodotti fa tendono a sopravvivere molto più a lungo del dovuto.
Conclusione
La scheda di valutazione QA è lo strumento più importante di un programma di qualità. La mantenga mirata, la ponderi in base all’impatto, definisca gli errori bloccanti, la calibri e la aggiorni man mano che il suo business cambia. Poi la applichi al 100% delle conversazioni con l’automazione, di persone e di AI, così lo standard che ha definito con tanto impegno raggiunge davvero ogni interazione, non solo un campione. È così che una scheda smette di essere una checklist e diventa il motore di una qualità costante.
Domande frequenti
Come si calcola un punteggio QA?
Sommi i punti ottenuti, poi li divida per i punti effettivamente disponibili in quella conversazione, non per il totale nominale della scheda. Se un criterio da 20 punti non si applicava, il denominatore è 80, non 100. Un operatore con 68 punti ottiene l’85% con il metodo corretto e il 68% con quello sbagliato.
Come possiamo migliorare un punteggio QA basso?
Guardi i dati per criterio, non il totale. Un 72% causato dal mancare sistematicamente la verifica si corregge in dieci minuti. Lo stesso 72% distribuito in modo uniforme su tutti i criteri è un problema completamente diverso. Se non riesce a vedere quali criteri abbassano il punteggio, la prima cosa da sistemare è il suo report.
Come creiamo una checklist QA?
Parta dalle sue ultime 50 escalation e rimborsi, associ a ciascuno il comportamento che lo avrebbe evitato e lasci che la frequenza definisca i criteri. Limiti l’elenco a 20 voci e scriva una definizione di una frase per ogni livello di punteggio.
Quanti criteri dovrebbe avere una scheda di valutazione QA?
Meno di quanti pensa. Tenga i criteri che prevedono i risultati per il cliente e non superi i cinque errori bloccanti. Una scheda sovraccarica diluisce il segnale, rallenta la valutazione e richiede più calibrazione per ogni giudizio in più.
Si può usare la stessa scheda di valutazione per agenti AI e operatori?
Sì, per i criteri che descrivono il risultato per il cliente: risposta corretta e completa, policy rispettata, prossimo passo chiaro e un passaggio di consegne pulito. Aggiunga poche voci che valgono per un solo tipo di agente, come la base nei suoi contenuti per l’agente AI e le note del caso per le persone, e segni N/A quelle dell’altro. Confronti i due solo sulle voci comuni.
Chi corregge una voce non superata in una conversazione di un agente AI?
Chi gestisce ciò che l’agente AI ha usato: il prompt, l’articolo di assistenza, il testo della policy o l’impostazione. Per questo ogni voce non superata deve registrare la fonte con cui è stata verificata. La persona che ha preso in carico la conversazione viene valutata solo sulla propria gestione.
Una scheda di valutazione QA può essere applicata in automatico?
Sì. Il controllo qualità automatico applica la sua scheda a ogni conversazione, di persone o di AI, in modo coerente, mentre le persone si occupano di calibrazione, ricorsi e coaching. In Kaizo, AutoPilot valuta ogni conversazione quando viene risolta e collega ogni punteggio alle evidenze nella conversazione.
Servono schede diverse per chat, email e voce?
Di solito sì, almeno con pesi diversi. Le categorie principali restano le stesse, ma criteri come il ritmo delle risposte o la gestione della chiamata sono specifici del canale.
Fonti
- Zendesk, formula dell’internal quality score
- Balto, pesi per sezione
- VereQuest, scheda di comportamenti da 100 punti e gestione del N/A
- Five9, pesi sui risultati e cadenza della calibrazione
- MaestroQA, categorie di errore bloccante
- Call Centre Helper, dimensione del campione
- HiveDesk, dimensione del campione per anzianità
- OttoQA, valutazioni per operatore (affermazione di un fornitore, senza fonti)
- C2Perform, parametri di confidenza
- Fasce di interpretazione del kappa di Landis e Koch
Le cifre sul margine di errore in questa pagina sono calcolate, non tratte da fonti, e sono indicate come tali dove compaiono. Le citazioni dei professionisti provengono da discussioni pubbliche su r/callcentres, collegate nel testo, e sono riportate nell’originale inglese con una traduzione.
Letture correlate
- 5 modelli gratuiti di scheda di valutazione QA (in inglese)
- Criteri di errore bloccante nel QA (in inglese)
- Scrivere criteri QA che l’AI può davvero valutare (in inglese)
- Calibrazione QA: sessioni che eliminano le distorsioni nei punteggi (in inglese)
Applichi la sua scheda di valutazione QA al 100% delle conversazioni
Prenoti un incontro di 30 minuti e scopra come Kaizo valuta ogni conversazione, di persone o di AI, con la sua scheda e trasforma i risultati in coaching.






