
Eine QA-Scorecard, im Callcenter oft Call Center Quality Monitoring Scorecard genannt, ist eine gewichtete Liste von Kriterien, nach der ein Supportteam jede Kundenkonversation bewertet, ergänzt um K.-o.-Kriterien für die wenigen Fehler, die eine Konversation allein durchfallen lassen. Sie macht aus „gutem Service“ Zeilen, die zwei Reviewer oder eine KI gleich bewerten, und die Summe wird zum Qualitätsscore für Coaching und Reporting. Unten finden Sie eine QA-Scorecard-Vorlage zum Kopieren, die Konversationen von Menschen und KI-Agenten auf einer Karte bewertet, dazu die Rechnung zu Gewichtung, N/A und Stichprobe, die die meisten Leitfäden weglassen.
Kurz gesagt
- Eine QA-Scorecard hat fünf Teile: Kriterien, Gewichte, eine Bewertungsskala, K.-o.-Kriterien und einen Beleg für jeden Score.
- Veröffentlichte Scorecards gewichten dieselben Abschnitte sehr unterschiedlich. Leiten Sie Ihre Gewichte deshalb aus Ihren eigenen Eskalationen ab und prüfen Sie, ob sie CSAT vorhersagen.
- Trifft ein Kriterium nicht zu, nehmen Sie seine Punkte aus dem Nenner: Wer es mit null bewertet, verschiebt ein einzelnes Ergebnis um bis zu 17 Punkte.
- Bei fünf Prüfungen pro Agent liegt die Fehlertoleranz einer Bestehensquote bei etwa 26 Punkten. Das reicht zum Coachen, nicht zum Ranking.
- Teilen sich Menschen und KI-Agenten eine Queue, hält eine Scorecard mit gemeinsamen Kriterien, Zeilen pro Bearbeiter und K.-o.-Kriterien pro Bearbeiter beide am selben Maßstab.
Was ist eine QA-Scorecard (Call Center Quality Monitoring Scorecard)?
Eine QA-Scorecard ist eine strukturierte Liste gewichteter Kriterien, mit der die Qualität einer Konversation im Kundenservice bewertet wird. Jedes Kriterium beschreibt einen Teil dessen, was eine gute Interaktion ausmacht, und jede Konversation wird daran gemessen. Das Ergebnis ist ein Gesamt-Qualitätsscore, der Coaching und Reporting steuert.
Die Scorecard ist die greifbar gemachte Definition von Qualität. Statt des vagen Gefühls, eine Konversation sei „gut“ gewesen, zerlegt die Scorecard Qualität in konkrete, messbare Elemente (wurde das Anliegen gelöst, stimmte der Ton, wurden die Richtlinien eingehalten) und gibt jedem ein Gewicht. Erst dadurch wird QA einheitlich, coachbar und belastbar.
Die Scorecard ist das gesamte Instrument: Kriterien, Gewichte, Skala und K.-o.-Kriterien. Die detaillierte Anleitung, was bei jedem Kriterium welche Bewertung ergibt, heißt meist QA-Bewertungsraster. Eine gute Scorecard enthält diese Anleitung für jedes Kriterium, damit Reviewer und KI jede Zeile gleich lesen.
Warum die QA-Scorecard so wichtig ist
An der Scorecard entscheidet sich, ob ein QA-Programm gelingt oder scheitert. Eine gute Scorecard:
- Schafft Einheitlichkeit, damit jeder Reviewer und jede KI-Bewertung nach demselben Maßstab bewertet.
- Macht Feedback konkret, damit Agents genau wissen, was sie verbessern sollen, und nicht nur ihren Gesamtscore kennen.
- Verbindet Qualität mit Ergebnissen, indem sie die Verhaltensweisen bewertet, die CSAT und Lösungsquote tatsächlich treiben.
- Hält einer Prüfung stand, wenn ein Agent einen Score anfechtet oder eine Aufsichtsbehörde Belege verlangt.
Eine überladene oder vage Scorecard bewirkt das Gegenteil: QA wird zu subjektivem Abhaken, dem Agents misstrauen und mit dem Manager nichts anfangen können.
Was eine gute QA-Scorecard enthält
Jede wirksame Scorecard hat einige gemeinsame Bestandteile:
- Klare Kriterien, formuliert als objektive, beantwortbare Fragen.
- Gewichte, die widerspiegeln, wie wichtig jedes Kriterium für Ihr Unternehmen ist.
- Eine Bewertungsskala, oft Ja/Nein oder eine Skala von 1 bis 5 für Kriterien mit Abstufungen.
- K.-o.-Kriterien (Auto-Fail) für compliance-kritische Verhaltensweisen.
- Abschnitte oder Kategorien, die zusammengehörige Kriterien für ein lesbares Reporting bündeln.
Kategorien und Kriterien einer QA-Scorecard
Die meisten QA-Scorecards im Kundenservice ordnen ihre Kriterien in vier Kategorien:
| Kategorie | Beispielkriterien |
|---|---|
| Lösung | Wurde das Anliegen vollständig gelöst? Waren die Informationen korrekt? Wurde die richtige Lösung angeboten? |
| Compliance | Wurde der Kunde verifiziert? Wurden die vorgeschriebenen Hinweise gegeben? Wurden die Richtlinien eingehalten? |
| Kommunikation | War der Ton empathisch und professionell? War die Antwort klar? Wurde das Anliegen des Kunden anerkannt? |
| Effizienz | Wurde das Anliegen ohne unnötige Weiterleitungen, Wiederholungen oder Verzögerungen bearbeitet? |
Beispiele für QA-Scorecards pro Kanal
Eine Scorecard sollte sich dem Kanal anpassen. Hier vereinfachte Beispiele.
QA-Scorecard für Chat und Messaging
| Kriterium | Gewicht |
|---|---|
| Anliegen korrekt gelöst | 30 % |
| Antwortzeit und Tempo angemessen | 15 % |
| Klare, gut formatierte, empathische Nachrichten | 25 % |
| Richtiger Prozess und Verifizierung eingehalten | 20 % |
| Sauberer Abschluss und nächste Schritte | 10 % |
QA-Scorecard für E-Mail und Tickets
| Kriterium | Gewicht |
|---|---|
| Vollständige, korrekte Lösung mit möglichst wenigen Antworten | 35 % |
| Professioneller, markengerechter Ton und korrekte Grammatik | 25 % |
| Compliance und Richtlinien eingehalten | 25 % |
| Klare Struktur und nächste Schritte | 15 % |
QA-Scorecard für Telefonie und Anrufe
| Kriterium | Gewicht |
|---|---|
| Anliegen gelöst, korrekte Informationen | 30 % |
| Identitätsprüfung und Compliance | 25 % |
| Empathie, aktives Zuhören, Ton | 25 % |
| Gesprächsführung und Effizienz | 20 % |
So bauen Sie eine QA-Scorecard auf
- Gehen Sie von Ihrer Qualitätsdefinition aus. Notieren Sie, wie eine hervorragende Konversation für Ihr Team aussieht, und gruppieren Sie das in Kategorien.
- Formulieren Sie objektive Kriterien. Schreiben Sie jedes als klare Frage, die ein Reviewer oder eine KI einheitlich beantworten kann. Vermeiden Sie vage Begriffe wie „guter Service“.
- Vergeben Sie Gewichte. Geben Sie dem mehr Gewicht, was Kundenergebnisse treibt. Lösung und Compliance wiegen meist am schwersten.
- Legen Sie K.-o.-Kriterien fest. Entscheiden Sie, welche Fehler die ganze Konversation durchfallen lassen, unabhängig vom Rest.
- Pilotieren und kalibrieren Sie. Bewerten Sie eine Stichprobe mit Ihrem Team, vergleichen Sie die Ergebnisse und schärfen Sie die Formulierungen, bis die Bewertung einheitlich ist.
- Überprüfen Sie regelmäßig. Passen Sie die Scorecard an, wenn sich Produkte, Richtlinien und Kundenbedürfnisse ändern.
Kostenlose Vorlage für die QA-Scorecard
Die Vorlage im nächsten Abschnitt ist die richtige, wenn Menschen und KI-Agenten in denselben Queues antworten. Brauchen Sie nur eine Scorecard für einen Kanal, etwa Live-Chat, E-Mail, Telefon oder Beschwerden, starten Sie mit unseren fünf fertigen Kanal-Scorecards (auf Englisch) und passen Sie die Gewichte an.
QA-Scorecard-Vorlage für menschliche und KI-Agenten
Eine QA-Scorecard für menschliche und KI-Agenten ist eine einzige Karte aus drei Teilen: gemeinsame Kriterien, die jede Konversation gleich bewerten, einige Zeilen, die nur für den KI-Agenten oder nur für Menschen gelten, und K.-o.-Kriterien pro Bearbeiter. Jede bewertete Zeile hält ihren Beleg fest, sodass jeder nachprüfen kann, warum sie bestanden hat oder nicht.
Kopieren Sie die Tabelle in eine Tabellenkalkulation oder Ihr QA-Tool. Die Punkte sind ein Beispiel: Passen Sie sie an Ihre eigenen Eskalationen an, wie weiter unten unter Gewichtung beschrieben. Bewerten Sie jede Zeile mit vollen Punkten oder null und markieren Sie sie mit N/A, wenn sie nicht zutrifft.
| # | Kriterium | Gilt für | Bestanden, wenn | Punkte | Festzuhaltender Beleg |
|---|---|---|---|---|---|
| 1 | Richtige Antwort | Beide | Jede Angabe stimmt für den Fall dieses Kunden | 20 | Die Zeile mit der Angabe und der Artikel oder die Richtlinie, mit der sie übereinstimmen muss |
| 2 | Vollständige Antwort | Beide | Jeder Teil der Frage ist beantwortet, auch Bedingungen | 10 | Der Teil der Frage, der fehlt |
| 3 | Richtlinie eingehalten | Beide | Nichts wird außerhalb der schriftlichen Richtlinie angeboten, zugesagt oder abgelehnt | 15 | Das Angebot oder die Ablehnung, dazu Richtlinie und Version |
| 4 | Klarer nächster Schritt | Beide | Der Kunde weiß, was als Nächstes passiert, oder das Anliegen ist gelöst | 10 | Die abschließende Nachricht |
| 5 | Ton passt zur Situation | Beide | Die Antwort passt zu Ihrer Marke und zur Lage des Kunden | 5 | Die unpassende Zeile, zitiert |
| 6 | Übergabe | Beide, N/A ohne Weiterleitung | Bei einer Weiterleitung wird der Kontext übergeben und vom Empfänger genutzt | 10 | Die Übergabenotiz und die erste Antwort des Empfängers |
| 7 | Auf Ihren Inhalten gestützt | Nur KI-Agent | Jede Angabe stammt aus einem veröffentlichten Hilfeartikel oder einer Richtlinie | 5 | Der verwendete Artikel oder „keine Quelle gefunden“ |
| 8 | Bleibt im Rahmen | Nur KI-Agent | Er bearbeitet nur die Themen und Aktionen, die ihm erlaubt sind | 5 | Die Anfrage außerhalb des Rahmens und die Antwort |
| 9 | Eskaliert oder benennt Unsicherheit | Nur KI-Agent | Er übergibt bei den festgelegten Auslösern und rät nicht | 5 | Die auslösende Zeile und was der KI-Agent danach tat |
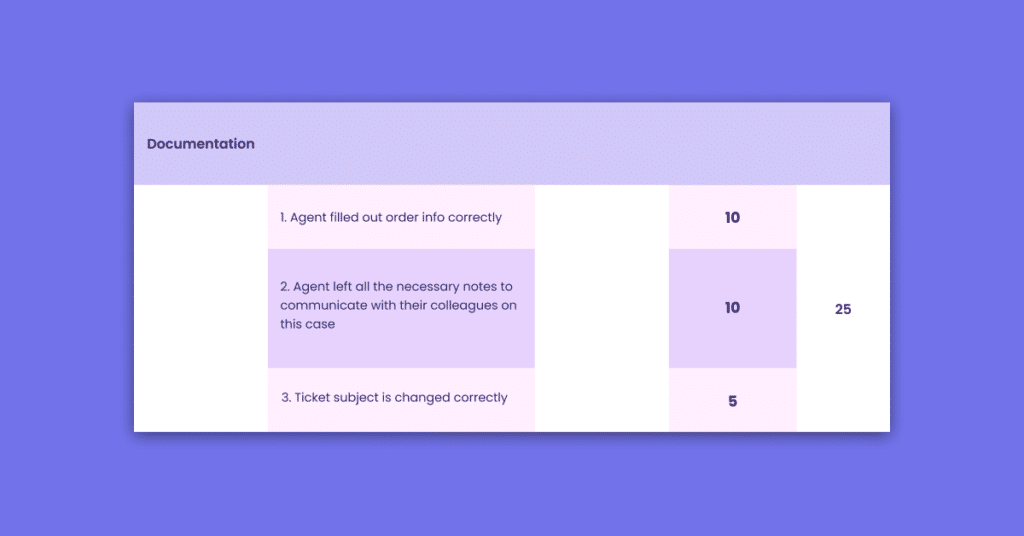
| 10 | Fallnotizen und Tags | Nur Mensch | Die nächste Person kann weitermachen, ohne den Kunden erneut zu fragen | 8 | Die fehlende Notiz oder der fehlende Tag |
| 11 | Zusage eingehalten | Nur Mensch, N/A ohne Zusage | Ein zugesagter Rückruf oder ein Update kam rechtzeitig | 7 | Die Zusage und das Datum, an dem sie eingehalten oder verpasst wurde |
Die Karte ergibt 100 Punkte: 70 gemeinsam, 15 für den KI-Agenten und 15 für Menschen. In jeder Konversation sind die Zeilen des jeweils anderen Bearbeiters N/A, also kann eine Konversation höchstens 85 Punkte erreichen, ohne Weiterleitung 75. Teilen Sie durch die verfügbaren Punkte, genau wie in der N/A-Regel weiter unten, und jede Konversation erhält trotzdem einen Prozentwert.
Vergleichen Sie Menschen und KI-Agenten nur auf den gemeinsamen Zeilen und Thema für Thema, denn der KI-Agent bekommt meist die leichteren Themen. Unser Leitfaden zu einer Scorecard für Mensch und KI-Agent zeigt diesen Vergleich an einem Rechenbeispiel, ebenso die Variante, die Zeilen pro Bearbeiter als Bestanden oder Nicht bestanden neben dem Score zu führen statt als Punkte. Warum es die Zeilen nur für KI gibt und welche menschlichen Kriterien für einen Bot wegfallen, erklärt der Leitfaden zur Scorecard für KI-Agenten.
K.-o.-Kriterien für menschliche und KI-Agenten
K.-o.-Kriterien übersteuern den Score, egal wer geantwortet hat. Beschränken Sie sie auf fünf, machen Sie jedes im Transkript prüfbar und berichten Sie sie neben dem Score statt darin.
| K.-o.-Kriterium | Gilt für | So prüfen Sie es |
|---|---|---|
| Kontodaten herausgegeben, bevor die Identität geprüft ist | Beide | Prüfschritt fehlt vor der ersten Kontoangabe |
| Erstattung, Gutschrift oder Ausnahme außerhalb der Richtlinie zugesagt | Beide | Die Zusage, zitiert und mit der schriftlichen Richtlinie verglichen |
| Kartennummern oder Passwörter in der Konversation erfragt oder wiederholt | Beide | Die Zeile mit den Daten |
| Pflichtauslöser für eine Übergabe ignoriert, etwa der Wunsch nach einem Menschen oder eine rechtliche Drohung | KI-Agent | Die auslösende Zeile und die Antworten danach |
| Beleidigende oder diskriminierende Sprache gegenüber dem Kunden | Beide | Die Zeile, zitiert |
Die Zeile für den KI-Agenten fehlt auf Scorecards für Menschen. Eine Person, die nach einer Führungskraft gefragt wird, weiß, dass sie weiterleiten muss. Ein KI-Agent muss das gesagt bekommen, und fehlt in seinen Anweisungen ein Auslöser, hält er den Kunden in jeder Konversation, die ihn trifft, in einer Schleife fest.
So halten Sie die Belege fest
Jede bewertete Zeile braucht einen Nachweis, den jemand anderes prüfen kann, ohne die ganze Konversation neu zu lesen. Speichern Sie pro Zeile fünf Dinge: den Link zur Konversation, die zitierte Zeile oder Zeilen, den Artikel oder die Richtlinie, gegen die geprüft wurde, die Version der Scorecard und wer bewertet hat, ein Reviewer oder ein automatisierter Bewerter.
Der Beleg entscheidet, wer handelt. Eine nicht bestandene Zeile in der Konversation einer Person geht ins Coaching. Eine nicht bestandene Zeile in der Konversation eines KI-Agenten geht an die Person, die für den Prompt, den Hilfeartikel oder die Einstellung verantwortlich ist, nie an die Person, die die Konversation übernommen hat. In den QA-Scorecards von Kaizo bewertet AutoPilot jede Konversation, sobald sie gelöst ist, fügt einen Kommentar hinzu, der den Score erklärt, und verknüpft jeden Score mit dem Beleg in der Konversation.
Rechenbeispiel: eine Konversation mit einem Menschen, eine mit einem KI-Agenten
Zwei Konversationen aus derselben Abrechnungs-Queue, bewertet mit der Karte oben. Die Details sind erfunden, um die Rechnung zu zeigen; es sind keine Kundendaten.
| Kriterium | Konversation A: Mensch, Tarifwechsel, keine Weiterleitung | Konversation B: KI-Agent, Erstattungsanfrage, an einen Menschen weitergeleitet |
|---|---|---|
| 1 Richtige Antwort (20) | 20: neuer Preis und Startdatum stimmen mit der Preisliste überein | 0: „Sie können es innerhalb von 30 Tagen gegen volle Erstattung zurückgeben.“ Die Erstattungsrichtlinie v3 sagt 14 Tage für geöffnete Artikel |
| 2 Vollständige Antwort (10) | 10 | 10 |
| 3 Richtlinie eingehalten (15) | 15 | 0: volle Erstattung für einen geöffneten Artikel zugesagt |
| 4 Klarer nächster Schritt (10) | 0: endet mit „Ich kümmere mich darum“, ohne Zeitpunkt oder Kanal | 10: sagt dem Kunden, dass eine Kollegin in diesem Chat übernimmt |
| 5 Ton passt zur Situation (5) | 5 | 5 |
| 6 Übergabe (10) | N/A | 0: Bestellnummer übergeben, aber die Erstattungszusage fehlt in der Notiz |
| 7 bis 9 Zeilen für den KI-Agenten (15) | N/A | 10: im Rahmen geblieben und auf Wunsch eskaliert (10); nicht gestützt (0), kein Artikel nennt 30 Tage |
| 10 Fallnotizen und Tags (8) | 0: keine Notiz zum Tarifwechsel | N/A |
| 11 Zusage eingehalten (7) | 7: Bestätigungs-E-Mail am selben Tag verschickt | N/A |
| Erreichte / verfügbare Punkte | 57 / 75 | 35 / 85 |
| Score | 76 % | 41 % |
| K.-o.-Kriterium | Keines | Erstattung außerhalb der Richtlinie zugesagt |
| Geht an | Coaching zu nächsten Schritten und Fallnotizen | Die verantwortliche Person für den Erstattungsartikel und die Erstattungsanweisungen des KI-Agenten |
Konversation B wird mit 41 % und einem K.-o.-Vermerk berichtet, nicht als eine einzige Null verbucht. Die Person, die übernommen hat, wird in ihrer eigenen Konversation dafür bewertet, wie sie mit der zurückgenommenen Zusage umgegangen ist, sodass der Fehler des KI-Agenten nie auf ihrem Score landet. Nur auf den gemeinsamen Zeilen erreicht A 50 von 60 und B 25 von 70. Diese Werte nutzen Sie, wenn Sie beide Bearbeiter Thema für Thema vergleichen.
Eine QA-Scorecard gewichten und bewerten
Erst die Gewichtung macht aus einer Checkliste (auf Englisch) einen aussagekräftigen Score. Einige Grundsätze:
- Gewichten Sie nach Wirkung. Kriterien, die Lösung und Compliance betreffen, sollten kosmetische Kriterien überwiegen.
- Halten Sie die Skala einfach. Ja/Nein lässt sich leicht einheitlich anwenden; nutzen Sie eine Skala von 1 bis 5 nur dort, wo Abstufungen wirklich zählen.
- Normieren Sie auf 100. Ein Gesamtprozentwert lässt sich leicht im Zeitverlauf verfolgen und zwischen Teams vergleichen.
- Gewichten Sie Subjektives nicht zu stark. Je mehr ein Kriterium von der Meinung des Reviewers abhängt, desto mehr Kalibrierung braucht es.
Die veröffentlichten Scorecards widersprechen sich, und genau darum geht es
Es gibt keine branchenübliche Gewichtung, und die Anbieter, die ihre veröffentlichen, sind sich nicht einig. Balto gewichtet nach Abschnitten: Begrüßung 10 %, Kommunikation 25 %, Compliance 20 %, Lösung 25 %, Abschluss 20 %. VereQuest veröffentlicht eine 100-Punkte-Scorecard für Verhaltensweisen, die Problemlösung mit 20, Empathie mit 15 und Verantwortungsübernahme mit 15 gewichtet, die Begrüßung mit 5 und die Ansprache des Kunden mit Namen mit 2. Five9 gewichtet Ergebnisse statt Verhaltensweisen: CSAT 30 %, FCR 25 %, QA-Score 20 %, AHT 15 %, Adherence 10 %.
Balto vergibt dreißig von hundert Punkten dafür, wie die Konversation beginnt und endet. Unsere Kanal-Scorecards oben geben dafür fast nichts. Keines von beiden ist falsch. Gewichte sind eine Geschäftsentscheidung, keine Best Practice zum Abschreiben, also leiten Sie Ihre eigenen ab:
- Gehen Sie von dem aus, was tatsächlich schiefläuft. Nehmen Sie Ihre letzten 50 Eskalationen, Erstattungen und Beschwerden und ordnen Sie jeder das Verhalten zu, das sie verhindert hätte. Gehen 30 davon auf falsche Informationen zurück, die selbstsicher gegeben wurden, verdient Genauigkeit mehr als 5 Punkte.
- Prüfen Sie, ob die Gewichte etwas vorhersagen. Bewerten Sie 100 Konversationen und korrelieren Sie dann die Abschnittsscores mit CSAT oder Lösungsergebnis genau dieser Konversationen. Hat Ihr Ton-Score keinen Zusammenhang damit, ob der Kunde zufrieden war, sollte er keine 20 Punkte tragen. Das ist ein halber Tag in einer Tabellenkalkulation, und fast niemand macht es.
Die N/A-Falle, die die meisten Scorecards unbemerkt verfälscht
Trifft ein Kriterium auf eine Konversation nicht zu, nehmen Sie seine Punkte aus dem Nenner. Bewerten Sie es nicht mit null, und lassen Sie es nicht stillschweigend drin.
Die Rechnung ist wichtiger, als es klingt. Ein Agent erreicht 68 Punkte auf einer Scorecard, bei der ein 20-Punkte-Kriterium tatsächlich nicht anwendbar war. Geteilt durch die reduzierte Summe ergibt das 68 von 80, also 85 %. Geteilt durch die ursprünglichen 100 ergibt es 68 %. Das ist ein Unterschied von 17 Punkten, allein durch eine Buchhaltungsentscheidung.
VereQuest regelt das ausdrücklich und hält fest, dass bei Verwendung von N/A “the total % or total # of points is reduced by that amount” (der Gesamtprozentwert oder die Gesamtpunktzahl wird um diesen Betrag reduziert). Prüfen Sie, was Ihr Tool standardmäßig macht, denn nicht alle machen es richtig. Wenn Sie die allgemeine Form suchen: Der interne Qualitätsscore von Zendesk ist die Summe der Bewertungen geteilt durch den maximal verfügbaren Score über alle Kategorien. Das entscheidende Wort ist verfügbar, nicht möglich.
K.-o.-Kriterien (Auto-Fail)
Manche Fehler sind so gravierend, dass die Konversation durchfallen sollte, auch wenn der Score ansonsten stark ist. Typische K.-o.-Kriterien sind eine übersprungene Identitätsprüfung, ein fehlender rechtlicher Hinweis, falsche regulierte Informationen oder ein schwerer Vertrauensbruch gegenüber dem Kunden. K.-o.-Kriterien ausdrücklich festzulegen hält Ihre Scorecard ehrlich: Eine Konversation, die jedes Kommunikationskriterium erfüllt, aber gegen Compliance verstößt, ist keine gute Konversation, und der Score sollte das zeigen.
MaestroQA nennt drei legitime Kategorien: Verstöße gegen Compliance und Sicherheit, etwa offengelegte Kartendaten oder eine übersprungene Verifizierung, wissentlich falsche Informationen und beleidigendes Verhalten. Drei Regeln machen K.-o.-Kriterien tragbar:
- Begrenzen Sie die Liste auf fünf. Wenn alles kritisch ist, ist nichts kritisch.
- Jedes K.-o.-Kriterium muss objektiv überprüfbar sein. Keines darf vom Urteil eines Reviewers über den Ton abhängen. Bewerten Sie den Ton; lassen Sie nie wegen des Tons durchfallen.
- Berichten Sie K.-o.-Fälle getrennt vom Score. Ein Agent mit einem K.-o.-Fall und neunzehn starken Konversationen ist ein anderes Problem als ein Agent mit einem Schnitt von 60 %. Beides in einem gleitenden Durchschnitt zu vermischen verdeckt beides, und eine einzige Null in einem Monat mit fünf Konversationen senkt den Schnitt allein um 20 Punkte.
Was ist ein guter QA-Score?
Es gibt keine allgemeingültige Bestehensgrenze, denn sie hängt davon ab, wie anspruchsvoll Ihre Scorecard ist. Die meisten ausgereiften Programme legen einen Zielkorridor fest, oft bei etwa 85 bis 90 % und darüber, und behandeln Scores darunter als Anlass für Coaching. Zwei Dinge zählen mehr als der Gesamtwert: die K.-o.-Kriterien, die ihn übersteuern, und der Trend pro Agent und Team über die Zeit, vor allem, ob er mit CSAT korreliert. Ein einzelner Score sagt wenig; ein steigender Trend, der mit zufriedeneren Kunden einhergeht, sagt alles.
Es gibt einen härteren Grund, sich nicht auf den Gesamtwert zu fixieren, und er liegt in der Arithmetik, nicht in der Philosophie.
Wie viele Konversationen sollten Sie prüfen?
Prüfen Sie 5 bis 10 Konversationen pro Agent und Monat, wenn es um Coaching geht, und lesen Sie das Ergebnis als Hinweis, nicht als Rangliste. Bei fünf Prüfungen liegt die Fehlertoleranz der Bestehensquote eines Agents bei 95 % Konfidenz bei etwa 26 Punkten. Für Rankings oder eine an den Score geknüpfte Vergütung brauchen Sie viel größere Stichproben oder die Bewertung jeder Konversation.
Die veröffentlichten Empfehlungen unterscheiden sich um mehr als das Zehnfache, und keine passt zu den anderen.
Call Centre Helper empfiehlt 5 bis 6 Anrufe pro Agent, wobei Garry Gormley von FAB Solutions das als den idealen Punkt zwischen Fairness und Ressourcenaufwand bezeichnet. HiveDesk empfiehlt 5 bis 10 pro Agent und Monat, für neue Mitarbeitende in ihren ersten 90 Tagen 10 bis 15. OttoQA plädiert für etwa 65 pro Agent und Monat, allerdings ist das ein Anbieterargument auf Basis aggressiver Volumenannahmen, und es nennt keine Quelle. C2Perform nennt die richtigen statistischen Parameter, 95 % Konfidenz und 5 % Fehlertoleranz mit Z = 1,96, druckt die Formel aber nie ab.
Hier also die Rechnung. Behandeln Sie jede geprüfte Konversation als bestanden oder nicht bestanden, gemessen an Ihrer Qualitätsschwelle. Die Fehlertoleranz für die tatsächliche Bestehensquote eines Agents bei 95 % Konfidenz, unter der Annahme, dass diese Quote wirklich bei 90 % liegt:
| Geprüfte Konversationen pro Agent | Fehlertoleranz |
|---|---|
| 5 | plus/minus 26,3 Punkte |
| 10 | plus/minus 18,6 Punkte |
| 25 | plus/minus 11,8 Punkte |
| 50 | plus/minus 8,3 Punkte |
| 100 | plus/minus 5,9 Punkte |
Diese Werte sind berechnet, nicht aus einer Quelle übernommen: 1,96 multipliziert mit der Quadratwurzel aus p(1-p)/n. Eine Scorecard-Summe als binomiale Bestehensquote zu behandeln ist eine Vereinfachung, und zwar eine bewusste.
Ein Agent, der fünfmal geprüft wurde und 85 % erreicht, hat eine tatsächliche Qualitätsquote irgendwo zwischen etwa 59 % und 100 %. Sie können ihn nicht von einem Kollegen unterscheiden, der 95 % erreicht hat. Um das auf plus/minus 5 Punkte einzugrenzen, bräuchten Sie etwa 139 Prüfungen pro Agent und Monat.
Was Sie ehrlicherweise damit anfangen:
- Ranken Sie Agents nicht auf Basis kleiner Stichproben gegeneinander, und knüpfen Sie die Vergütung nicht an einen Schnitt aus fünf Konversationen. Die Messung trägt das nicht.
- Nutzen Sie kleine Stichproben für Coaching. Fünf Prüfungen sagen Ihnen nicht, dass ein Agent im untersten Dezil liegt, aber sie zeigen Ihnen, dass dieser Agent die Verifizierung überspringt. Ein konkretes, behebbares Verhalten zu finden braucht weit weniger Daten, als Menschen zu ranken.
- Aggregieren Sie nach oben. Fünf Prüfungen pro Agent in einem Team mit 40 Personen sind 200 Datenpunkte auf Teamebene, mehr als genug, um ein Prozess- oder Richtlinienproblem zu erkennen.
- Erhöhen Sie die Stichprobe, wo viel auf dem Spiel steht: bei neuen Mitarbeitenden, regulierten Konversationen und allen, deren Leistung formal in Frage steht.
Jede Konversation automatisch zu bewerten beseitigt dieses Problem, denn es bleibt keine Stichprobe übrig, die nicht repräsentativ sein könnte. Dafür entstehen andere Risiken, die weiter unten behandelt werden.
Kalibrierung: damit Scores fair bleiben
Kalibrierung macht eine Scorecard vertrauenswürdig. In einer Kalibrierungssitzung bewerten mehrere Reviewer, und zunehmend auch die KI, dieselben Konversationen unabhängig voneinander, vergleichen dann und gleichen Unterschiede ab. So werden mehrdeutige Kriterien sichtbar, die Auslegung wird vereinheitlicht, und es entsteht der gemeinsame Maßstab, durch den Agents ihre Scores akzeptieren. Ohne Kalibrierung ist ein „Score“ nur die Meinung einer Person. Mit ihr wird die Scorecard zu einem fairen, einheitlichen Maß, und genau darum geht es.
Die meisten Leitfäden hören hier auf, ohne zu sagen, wie eine bestandene Kalibrierung aussieht. Hinterlegen Sie Zahlen. Jeden Monat bewerten drei bis fünf Reviewer unabhängig dieselben sechs Konversationen, ohne Absprache, und messen dann zwei Dinge.
Streuung der Scores. Der Abstand zwischen der höchsten und der niedrigsten Gesamtbewertung derselben Konversation. Ein praxistauglicher Schwellenwert sind 10 Punkte auf einer 100-Punkte-Scorecard. Alles darüber bedeutet, dass die Kriteriendefinitionen mehrdeutig sind, nicht, dass ein Reviewer falsch liegt.
Übereinstimmung pro Kriterium. Finden Sie heraus, bei welchen Kriterien Ihre Reviewer uneins sind. Fast nie sind es die binären. Es sind die Ermessensskalen mit undefinierten Stufen. Wenn Sie ein formales Maß wollen: Cohens Kappa bereinigt die Übereinstimmung um den Zufall, und die gängigen Bänder nach Landis und Koch werten 0,41 bis 0,60 als mittelmäßig, 0,61 bis 0,80 als beachtlich und 0,81 bis 1,00 als nahezu vollkommen (hier zusammengefasst). Streben Sie 0,61 oder besser bei jedem Kriterium mit echtem Gewicht an. Unter 0,41 misst das Kriterium den Reviewer statt den Agent.
Korrigieren Sie die Scorecard, nicht den Reviewer. Wenn die Kalibrierung Uneinigkeit zeigt, schreiben Sie die Kriteriendefinition neu. Reviewer aufzufordern, sich mehr Mühe zu geben, übersteht die nächste mehrdeutige Konversation nicht.
Wie das aus Sicht der Agents aussieht
Scorecards werden von Managern entworfen und von Agents erlebt, und in der Lücke zwischen diesen beiden Sichtweisen scheitern Qualitätsprogramme leise. Support-Agents sprechen öffentlich und ausführlich über ihre Programme, und dieselben Muster kehren immer wieder.
Die Stichprobe fühlt sich wie Glück an, weil sie bei diesen Stichprobengrößen teilweise Glück ist. Ein Agent beschreibt, wie gut er bei den Konversationstypen abschneidet, in denen er am stärksten ist, und dann: “I followed my call flow to perfection on my new bookings and yet, they didn’t pull those.” (Sinngemäß: Bei den Neubuchungen habe ich meinen Gesprächsleitfaden perfekt befolgt, aber genau die wurden nicht gezogen.) (r/callcentres) Das ist keine Paranoia. Es ist eine Fehlertoleranz von etwa 26 Punkten, von innen erlebt.
Ungleiche Stichproben zerstören den Vergleich. Aus einem Thread über automatisierte QA: “This means my score might be based on 20 calls and my coworkers is based on 34.” (Sinngemäß: Mein Score beruht vielleicht auf 20 Anrufen, der meines Kollegen auf 34.) (r/callcentres) Wenn Sie Agents überhaupt ranken, halten Sie die Stichprobengröße konstant.
Ein einziges unkontrollierbares Ereignis kann einen gleitenden Durchschnitt ruinieren. “My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100.” (Sinngemäß: Mein Hund hat gebellt, und ich bekam eine Null für einen Anruf, der sonst perfekte 100 gewesen wäre.) (r/callcentres) Das ist das Durchschnittsproblem der K.-o.-Kriterien in freier Wildbahn.
Kriterien, die den Kontaktgrund ignorieren, wirken wie Beschäftigungstherapie. Ein Agent zur Bewertung des Beziehungsaufbaus: “I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment.” (Sinngemäß: Ich arbeite für einen Energieversorger und muss niemanden auf eine Reise mitnehmen, der nur eine Zahlung leisten will.) Wenn Ihre Scorecard dieselben Kriterien auf ein Passwort-Zurücksetzen und eine Sterbefallmeldung anwendet, wird sie abgelehnt und misst das Falsche. Nutzen Sie kanalspezifische oder kontaktgrundspezifische Scorecards, oder setzen Sie N/A richtig ein.
Reviewer-Fehler ohne Korrekturweg vergiften das ganze Programm. “3 of the 4 things that they said I didn’t ask, I absolutely did.” (Sinngemäß: Drei der vier Dinge, die ich angeblich nicht gefragt habe, habe ich sehr wohl gefragt.) (r/callcentres)
Die Lösung steht im selben Thread, beschrieben von einem QA-Analysten, dessen Programm funktioniert. Die Reviewer schicken sich Anrufe gegenseitig, “to make sure we’re being fair and accurate” (um sicherzugehen, dass sie fair und genau bewerten), Agents können jeden Score anfechten, und wenn das QA-Team falsch liegt, “own up to it and award the points back” (stehen sie dazu und geben die Punkte zurück). Das ist Kalibrierung plus ein Einspruchsverfahren, und es ist der Unterschied zwischen einer Scorecard, der die Leute vertrauen, und einer, die sie nur ertragen.
Bauen Sie den Einspruch also ein. Geben Sie Agents die bewertete Konversation, die Aufschlüsselung nach Kriterien, eine Frist für den Einspruch und eine benannte Person, die entscheidet. Verfolgen Sie Ihre Aufhebungsquote. Liegt sie nahe null, haben Agents vermutlich aufgegeben. Liegt sie über etwa 10 %, ist Ihre Scorecard mehrdeutig.
Häufige Fehler bei QA-Scorecards
- Zu viele Kriterien. Eine überladene Scorecard verwässert das Signal, auf das es ankommt, und verlangsamt die Bewertung.
- Vage Formulierungen. Subjektive Kriterien erzeugen uneinheitliche Scores und Widerstand bei Agents.
- Keine Gewichtung. Wer jedes Kriterium gleich behandelt, verdeckt, was wirklich zählt.
- Keine K.-o.-Kriterien. Ein Compliance-Verstoß geht durch, weil der Rest gut bewertet wurde.
- Einrichten und vergessen. Eine Scorecard, die nie aktualisiert wird, passt irgendwann nicht mehr zum Geschäft.
Manuelle oder automatisierte Bewertung der Scorecard
Eine Scorecard ist nur so nützlich wie Ihre Fähigkeit, sie anzuwenden. Von Hand bewertet erreicht selbst eine hervorragende Scorecard nur eine Stichprobe, oft 5 bis 10 Konversationen pro Agent und Monat. Mit KI bewertet, wie bei den Scorecards von Kaizo, wird dieselbe Scorecard einheitlich auf jede Konversation angewendet, ob Mensch oder KI, und Reviewer werden für Kalibrierung und Coaching frei.
| Manuelle Bewertung | Automatisierte Bewertung | |
|---|---|---|
| Abdeckung | Eine Stichprobe pro Agent | 100 % der Konversationen |
| Einheitlichkeit | Schwankt je nach Reviewer und Tag | Ein einheitlicher Maßstab |
| Aufwand | Stunden für Bewertungen pro Woche | Ins Coaching umgeschichtet |
Sehen Sie, wie automatisierte QA Ihre Scorecard auf jede Konversation anwendet und wie KI-Coaching die Ergebnisse in die Entwicklung der Agents überführt.
Zwei Teams zeigen, wie das aussieht. Bei UiPath hat Kaizo 100 % der QA automatisiert, mit 200 % ROI und einer Steigerung des Qualitätsscores um 8 %. SteelSeries hat die Zeit für QA halbiert, mit KI-Zusammenfassungen für lange, technische Tickets.
Eine Scorecard für beide. Kaizo bewertet jede Supportkonversation, ob Mensch oder KI, anhand Ihrer eigenen Scorecard und verknüpft jeden Score mit dem Beleg dahinter. Demo buchen.
Wann sich diese Scorecard nicht lohnt
Eine vollständig gewichtete Scorecard mit Beleg in jeder Zeile ist mehr, als manche Teams brauchen. Bearbeiten Sie nur einige Dutzend Konversationen pro Woche, lesen Sie sie selbst mit einer kurzen Checkliste; die Scorecard lohnt sich, sobald Sie nicht mehr alles lesen können. Haben Sie noch keinen KI-Agenten, streichen Sie die Zeilen 7 bis 9 und das K.-o.-Kriterium für den KI-Agenten, dann funktioniert die Vorlage als normale Scorecard für Menschen. Sind Ihre Richtlinien und Hilfeartikel nicht aufgeschrieben, holen Sie das zuerst nach: „richtige Antwort“ und „Richtlinie eingehalten“ lassen sich nicht an einem Maßstab bewerten, der nur in den Köpfen existiert. Und brauchen Sie eine Testsuite für einen KI-Agenten vor dem Start, etwa Regressionstests für Prompts, ist das eine andere Phase und eine andere Art von Tool als die Bewertung abgeschlossener Konversationen.
Versionierung Ihrer Scorecard
Ihre Scorecard wird sich ändern, und wenn sie das tut, brechen Sie Ihre eigene Trendlinie. Scores davor und danach sind nicht vergleichbar, und fast niemand warnt Sie davor.
Drei Praktiken genügen. Versionieren Sie die Scorecard und versehen Sie jede Bewertung mit der verwendeten Version. Ändern Sie Gewichte nie mitten im Quartal. Wenn Sie sie ändern, bewerten Sie 20 archivierte Konversationen sowohl mit der alten als auch mit der neuen Scorecard, damit Sie das Ausmaß der Verschiebung kennen, und vermerken Sie die Änderung auf jedem Diagramm, das sie überspannt.
Prüfen Sie die Scorecard zweimal im Jahr gegen Ihre aktuellen Eskalationsgründe. Kriterien, die vor zwei Produktgenerationen sinnvoll waren, überleben meist viel länger, als sie sollten.
Das Fazit
Die QA-Scorecard ist das wichtigste einzelne Instrument eines Qualitätsprogramms. Halten Sie sie fokussiert, gewichten Sie nach Wirkung, legen Sie K.-o.-Kriterien fest, kalibrieren Sie sie und passen Sie sie an, wenn sich Ihr Geschäft ändert. Wenden Sie sie dann mit Automatisierung auf 100 % der Konversationen an, von Menschen und KI, damit der Maßstab, den Sie mühsam definiert haben, tatsächlich jede Interaktion erreicht und nicht nur eine Stichprobe. So hört eine Scorecard auf, eine Checkliste zu sein, und wird zum Motor einheitlicher Qualität.
Häufig gestellte Fragen
Wie berechnet man einen QA-Score?
Addieren Sie die erreichten Punkte und teilen Sie sie durch die Punkte, die in dieser Konversation tatsächlich verfügbar waren, nicht durch die Gesamtpunktzahl der Scorecard. Traf ein 20-Punkte-Kriterium nicht zu, ist der Nenner 80, nicht 100. Ein Agent mit 68 Punkten erreicht mit der richtigen Methode 85 % und mit der falschen 68 %.
Wie verbessere ich einen niedrigen QA-Score?
Schauen Sie auf die Daten pro Kriterium, nicht auf die Summe. 72 %, die durch eine konsequent ausgelassene Verifizierung entstehen, sind in zehn Minuten behoben. Dieselben 72 %, gleichmäßig über alle Kriterien verteilt, sind ein völlig anderes Problem. Wenn Sie nicht sehen, welche Kriterien den Score nach unten ziehen, ist zuerst Ihr Reporting zu reparieren.
Wie erstelle ich eine QA-Checkliste?
Gehen Sie von Ihren letzten 50 Eskalationen und Erstattungen aus, ordnen Sie jeder das Verhalten zu, das sie verhindert hätte, und lassen Sie die Häufigkeit Ihre Kriterien bestimmen. Begrenzen Sie die Liste auf 20 Punkte und schreiben Sie für jede Bewertungsstufe eine Definition in einem Satz.
Wie viele Kriterien sollte eine QA-Scorecard haben?
Weniger, als Sie denken. Behalten Sie die Kriterien, die Kundenergebnisse vorhersagen, und begrenzen Sie die K.-o.-Kriterien auf fünf. Eine überladene Scorecard verwässert das Signal, verlangsamt die Bewertung und braucht für jede zusätzliche Ermessensfrage mehr Kalibrierung.
Kann man dieselbe QA-Scorecard für KI-Agenten und menschliche Agents nutzen?
Ja, für die Kriterien, die das Ergebnis für den Kunden beschreiben: eine richtige und vollständige Antwort, eingehaltene Richtlinien, ein klarer nächster Schritt und eine saubere Übergabe. Ergänzen Sie einige Zeilen, die nur für einen Bearbeiter gelten, etwa die Stützung auf Ihre Inhalte für den KI-Agenten und Fallnotizen für Menschen, und markieren Sie die Zeilen des anderen Bearbeiters mit N/A. Vergleichen Sie beide nur auf den gemeinsamen Zeilen.
Wer behebt eine nicht bestandene Zeile in der Konversation eines KI-Agenten?
Wer für das verantwortlich ist, was der KI-Agent genutzt hat: den Prompt, den Hilfeartikel, den Richtlinientext oder die Einstellung. Deshalb sollte jede nicht bestandene Zeile die Quelle festhalten, gegen die geprüft wurde. Die Person, die die Konversation übernommen hat, wird nur für ihr eigenes Vorgehen bewertet.
Kann eine QA-Scorecard automatisch bewertet werden?
Ja. Automatisierte QA wendet Ihre Scorecard einheitlich auf jede Konversation an, ob Mensch oder KI, während Menschen sich um Kalibrierung, Einsprüche und Coaching kümmern. In Kaizo bewertet AutoPilot jede Konversation, sobald sie gelöst ist, und verknüpft jeden Score mit dem Beleg in der Konversation.
Brauchen Sie unterschiedliche Scorecards für Chat, E-Mail und Telefonie?
Meist ja, zumindest unterschiedliche Gewichte. Die Kernkategorien bleiben gleich, aber Kriterien wie das Antworttempo oder die Gesprächsführung sind kanalspezifisch.
Quellen
- Zendesk, Formel des internen Qualitätsscores
- Balto, Gewichtung nach Abschnitten
- VereQuest, 100-Punkte-Scorecard für Verhaltensweisen und Umgang mit N/A
- Five9, Gewichtung nach Ergebnissen und Kalibrierungsrhythmus
- MaestroQA, Kategorien für K.-o.-Kriterien
- Call Centre Helper, Stichprobengröße
- HiveDesk, Stichprobengröße nach Betriebszugehörigkeit
- OttoQA, Bewertungen pro Agent (Anbieterangabe, ohne Quelle)
- C2Perform, Konfidenzparameter
- Landis und Koch, Interpretationsbänder für Kappa
Die Werte zur Fehlertoleranz auf dieser Seite sind berechnet, nicht aus einer Quelle übernommen, und an der jeweiligen Stelle so gekennzeichnet. Die Zitate aus der Praxis stammen aus öffentlichen Threads auf r/callcentres und sind im Text verlinkt.
Weiterlesen
- 5 kostenlose Vorlagen für QA-Scorecards (auf Englisch)
- K.-o.-Kriterien in der QA (auf Englisch)
- Scorecard-Kriterien schreiben, die eine KI wirklich bewerten kann (auf Englisch)
- QA-Kalibrierung: Sitzungen, die Bewertungsverzerrungen beseitigen (auf Englisch)
Wenden Sie Ihre QA-Scorecard auf 100 % der Konversationen an
Buchen Sie eine 30-minütige Demo und sehen Sie, wie Kaizo jede Konversation, ob Mensch oder KI, anhand Ihrer Scorecard bewertet und die Ergebnisse in Coaching verwandelt.






