
Karta oceny rozmów (QA scorecard) to ważona lista kryteriów, według której zespół obsługi klienta ocenia każdą rozmowę, uzupełniona o reguły błędów krytycznych dla tych nielicznych uchybień, które same przesądzają o negatywnej ocenie. Zamienia „dobrą obsługę” w pozycje, które dwóch recenzentów albo AI oceni tak samo, a suma staje się wynikiem jakości, na którym opierają się coaching i raporty. Poniżej znajdą Państwo gotowy do skopiowania szablon karty oceny, który ocenia rozmowy konsultantów i agentów AI na jednej karcie, oraz obliczenia wag, N/A i wielkości próbki, które większość poradników pomija.
W skrócie
- Karta oceny rozmów ma pięć części: kryteria, wagi, skalę oceny, reguły błędów krytycznych i zapis dowodów stojących za każdą oceną.
- Opublikowane karty ważą te same sekcje zupełnie inaczej, dlatego wagi warto wyprowadzić z własnych eskalacji i sprawdzić, czy przewidują CSAT.
- Gdy kryterium nie ma zastosowania, jego punkty trzeba usunąć z mianownika: ocena na zero potrafi przesunąć pojedynczy wynik o 17 punktów.
- Przy pięciu ocenach na konsultanta margines błędu odsetka zaliczeń wynosi około 26 punktów: to wystarczy do coachingu, ale nie do rankingu ludzi.
- Gdy konsultanci i agenci AI obsługują tę samą kolejkę, jedna karta ze wspólnymi kryteriami, pozycjami tylko dla jednej strony i błędami krytycznymi dla każdej z nich trzyma obie strony przy tym samym standardzie.
Czym jest karta oceny rozmów?
Karta oceny rozmów to uporządkowana lista ważonych kryteriów, służąca do oceny jakości rozmowy w obsłudze klienta. Każde kryterium opisuje część tego, jak wygląda dobra interakcja, a każda rozmowa jest oceniana według tych kryteriów, co daje ogólny wynik jakości, na którym opierają się coaching i raporty.
Kartę oceny warto traktować jako definicję jakości w konkretnej postaci. Zamiast mglistego poczucia, że rozmowa była „dobra”, karta rozbija jakość na konkretne, mierzalne elementy (czy sprawa została rozwiązana, czy ton był właściwy, czy przestrzegano procedur) i każdemu przypisuje wagę. To dzięki niej kontrola jakości jest spójna, przydatna w coachingu i możliwa do obrony.
Karta oceny to całe narzędzie: kryteria, wagi, skala i błędy krytyczne. Szczegółowe wytyczne, za co przyznaje się każdą ocenę, to zwykle kryteria oceny jakości rozmów (po angielsku „QA rubric”). Dobra karta zawiera takie wytyczne dla każdego kryterium, aby recenzenci i AI czytali każdą pozycję tak samo.
Dlaczego karta oceny rozmów ma znaczenie
To na karcie oceny większość programów kontroli jakości odnosi sukces albo ponosi porażkę. Dobra karta:
- Zapewnia spójność, dzięki czemu każdy recenzent, a także każda ocena AI, stosuje ten sam standard.
- Sprawia, że informacja zwrotna jest konkretna, więc konsultanci wiedzą dokładnie, co poprawić, a nie tylko znają ogólny wynik.
- Łączy jakość z rezultatami, oceniając zachowania, które naprawdę wpływają na CSAT i rozwiązanie sprawy.
- Wytrzymuje weryfikację, gdy konsultant kwestionuje wynik albo regulator prosi o dowody.
Przeładowana lub niejasna karta działa odwrotnie: zamienia kontrolę jakości w subiektywne odhaczanie rubryk, któremu konsultanci nie ufają, a na podstawie którego menedżerowie nie mogą działać.
Co zawiera dobra karta oceny rozmów
Każda skuteczna karta ma kilka wspólnych składników:
- Jasne kryteria, sformułowane jako obiektywne pytania, na które da się odpowiedzieć.
- Wagi, które odzwierciedlają, jak bardzo każde kryterium liczy się dla Państwa firmy.
- Skalę oceny, często tak/nie albo od 1 do 5 dla kryteriów wymagających niuansów.
- Reguły błędów krytycznych dla zachowań kluczowych z punktu widzenia zgodności.
- Sekcje lub kategorie, które grupują powiązane kryteria, aby raporty były czytelne.
Kategorie i kryteria karty oceny jakości
Większość kart oceny w obsłudze klienta dzieli kryteria na cztery kategorie:
| Kategoria | Przykładowe kryteria |
|---|---|
| Rozwiązanie | Czy sprawa została w pełni rozwiązana? Czy informacje były poprawne? Czy zaproponowano właściwe rozwiązanie? |
| Zgodność | Czy zweryfikowano klienta? Czy przekazano wymagane informacje? Czy przestrzegano procedur? |
| Komunikacja | Czy ton był empatyczny i profesjonalny? Czy odpowiedź była jasna? Czy dostrzeżono problem klienta? |
| Efektywność | Czy sprawę załatwiono bez zbędnych przekierowań, powtórzeń i opóźnień? |
Przykłady kart oceny dla poszczególnych kanałów
Karta oceny powinna dopasowywać się do kanału. Oto uproszczone przykłady.
Karta oceny dla czatu / komunikatorów
| Kryterium | Waga |
|---|---|
| Sprawa rozwiązana poprawnie | 30% |
| Odpowiedni czas odpowiedzi i tempo | 15% |
| Jasne, dobrze sformatowane, empatyczne wiadomości | 25% |
| Zachowana właściwa procedura i weryfikacja | 20% |
| Prawidłowe zakończenie i kolejne kroki | 10% |
Karta oceny dla e-maili / zgłoszeń
| Kryterium | Waga |
|---|---|
| Pełne, poprawne rozwiązanie w jak najmniejszej liczbie odpowiedzi | 35% |
| Profesjonalny ton zgodny z marką i poprawna gramatyka | 25% |
| Zachowana zgodność i procedury | 25% |
| Jasna struktura i kolejne kroki | 15% |
Karta oceny dla rozmów telefonicznych
| Kryterium | Waga |
|---|---|
| Sprawa rozwiązana, poprawne informacje | 30% |
| Weryfikacja tożsamości i zgodność | 25% |
| Empatia, aktywne słuchanie, ton | 25% |
| Prowadzenie rozmowy i efektywność | 20% |
Jak zbudować kartę oceny rozmów
- Proszę zacząć od własnej definicji jakości. Wypisać, jak wygląda świetna rozmowa w Państwa zespole, a następnie pogrupować te elementy w kategorie.
- Formułować obiektywne kryteria. Każde zapisać jako jasne pytanie, na które recenzent lub AI odpowie w spójny sposób. Unikać ogólników w rodzaju „dobra obsługa”.
- Przypisać wagi. Większą wagę nadać temu, co wpływa na rezultaty dla klienta. Rozwiązanie sprawy i zgodność zwykle ważą najwięcej.
- Ustalić reguły błędów krytycznych. Zdecydować, które uchybienia oznaczają negatywną ocenę całej rozmowy niezależnie od reszty.
- Przeprowadzić pilotaż i kalibrację. Ocenić pakiet rozmów z zespołem, porównać wyniki i dopracowywać sformułowania, aż ocena stanie się spójna.
- Regularnie przeglądać kartę. Aktualizować ją wraz ze zmianami produktów, procedur i potrzeb klientów.
Bezpłatny szablon karty oceny rozmów
Szablon z następnej sekcji warto skopiować, jeśli w tych samych kolejkach odpowiadają zarówno konsultanci, jak i agenci AI. Jeśli potrzebna jest karta dla jednego kanału (czat, e-mail, telefon lub reklamacje), lepiej zacząć od naszych pięciu gotowych kart dla poszczególnych kanałów (po angielsku) i dopasować wagi.
Szablon karty oceny rozmów dla konsultantów i agentów AI
Karta oceny rozmów dla konsultantów i agentów AI to jedna karta złożona z trzech części: wspólnych kryteriów, które oceniają każdą rozmowę tak samo, kilku pozycji dotyczących tylko agenta AI albo tylko człowieka oraz reguł błędów krytycznych dla każdej ze stron. Każda oceniona pozycja zapisuje swoje dowody, więc każdy może sprawdzić, dlaczego została zaliczona lub nie.
Tabelę można skopiować do arkusza kalkulacyjnego albo do narzędzia QA. Punkty są przykładowe: proszę dopasować je do własnych eskalacji, jak opisano niżej w części o wagach. Każdą pozycję ocenia się na pełną liczbę punktów albo na zero, a gdy nie ma zastosowania, oznacza się ją jako N/A.
| # | Kryterium | Dotyczy | Zaliczone, gdy | Punkty | Dowód do zapisania |
|---|---|---|---|---|---|
| 1 | Poprawna odpowiedź | Obu stron | Każdy fakt jest prawdziwy dla sprawy tego klienta | 20 | Zdanie z faktem oraz artykuł lub procedura, z którymi powinno się zgadzać |
| 2 | Pełna odpowiedź | Obu stron | Odpowiedziano na każdą część pytania, łącznie z warunkami | 10 | Pominięta część pytania |
| 3 | Zgodność z procedurami | Obu stron | Nic nie zostało zaoferowane, obiecane ani odmówione poza spisanymi zasadami | 15 | Oferta lub odmowa oraz zasada i jej wersja, którą narusza |
| 4 | Jasny kolejny krok | Obu stron | Klient wie, co dalej, albo sprawa jest rozwiązana | 10 | Wiadomość zamykająca |
| 5 | Ton dopasowany do sytuacji | Obu stron | Odpowiedź pasuje do marki i do stanu klienta | 5 | Cytat zdania, które odbiega |
| 6 | Przekazanie rozmowy | Obu stron, N/A bez przekazania | Kontekst zostaje przekazany, a odbiorca z niego korzysta | 10 | Notatka przy przekazaniu i pierwsza odpowiedź odbiorcy |
| 7 | Oparcie na Państwa treściach | Tylko agent AI | Każdy fakt pochodzi z opublikowanego artykułu pomocy lub procedury | 5 | Użyty artykuł albo „brak źródła” |
| 8 | Działanie w swoim zakresie | Tylko agent AI | Obsługuje tylko tematy i działania, na które ma zgodę | 5 | Prośba spoza zakresu i odpowiedź |
| 9 | Eskalacja lub przyznanie się do niewiedzy | Tylko agent AI | Przekazuje rozmowę przy ustalonych wyzwalaczach i nie zgaduje | 5 | Zdanie wyzwalające i to, co agent AI zrobił potem |
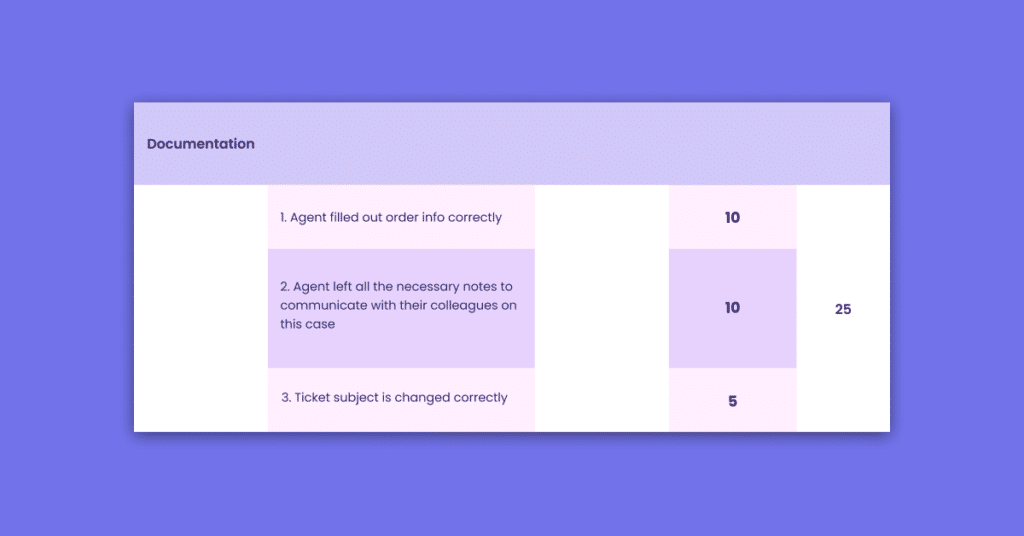
| 10 | Notatki i tagi | Tylko konsultant | Następna osoba może kontynuować bez ponownego pytania klienta | 8 | Brakująca notatka lub tag |
| 11 | Dotrzymane działanie następcze | Tylko konsultant, N/A bez obietnicy | Obiecany kontakt zwrotny lub aktualizacja nastąpiły na czas | 7 | Obietnica i data jej dotrzymania lub niedotrzymania |
Karta sumuje się do 100 punktów: 70 wspólnych, 15 dla agenta AI i 15 dla konsultantów. W każdej rozmowie pozycje drugiej strony mają status N/A, więc rozmowa może zdobyć najwyżej 85 punktów, a bez przekazania 75. Wynik liczy się przez podzielenie przez dostępne punkty, dokładnie według opisanej niżej zasady N/A, więc każda rozmowa nadal dostaje jeden wynik procentowy.
Konsultantów i agentów AI porównuje się tylko na wspólnych pozycjach, temat po temacie, bo agent AI zwykle dostaje łatwiejsze tematy. Nasz poradnik o wspólnej karcie oceny dla konsultantów i agentów AI pokazuje takie porównanie na przykładzie liczbowym, a także wariant, w którym pozycje jednej strony są oceniane jako zaliczone lub niezaliczone obok wyniku, a nie w punktach. Dlaczego istnieją pozycje tylko dla AI i które kryteria dla ludzi usunąć w przypadku bota, wyjaśnia przewodnik po karcie oceny agenta AI.
Reguły błędów krytycznych dla konsultantów i agentów AI
Błędy krytyczne mają pierwszeństwo przed wynikiem, niezależnie od tego, kto odpowiadał. Warto ograniczyć je do pięciu, każdy musi dać się sprawdzić w zapisie rozmowy, a raportuje się je obok wyniku, nie w nim.
| Błąd krytyczny | Dotyczy | Jak go sprawdzić |
|---|---|---|
| Dane konta udostępnione przed weryfikacją tożsamości | Obu stron | Brak kroku weryfikacji przed pierwszą informacją o koncie |
| Zwrot, rekompensata lub wyjątek obiecane poza procedurami | Obu stron | Cytat obietnicy zestawiony ze spisaną zasadą |
| Prośba o numer karty płatniczej lub hasło albo ich powtórzenie w rozmowie | Obu stron | Zdanie z tymi danymi |
| Zignorowany obowiązkowy wyzwalacz przekazania, np. prośba o rozmowę z człowiekiem lub groźba kroków prawnych | Agent AI | Zdanie wyzwalające i odpowiedzi po nim |
| Obraźliwy lub dyskryminujący język wobec klienta | Obu stron | Cytat zdania |
Wiersza dla agenta AI nie mają karty dla ludzi. Konsultant poproszony o kierownika wie, że trzeba przekazać rozmowę; agentowi AI trzeba to powiedzieć, a gdy w jego instrukcjach brakuje wyzwalacza, zatrzymuje klienta w pętli w każdej rozmowie, która na niego trafi.
Jak zapisywać dowody
Każda oceniona pozycja potrzebuje zapisu, który ktoś inny sprawdzi bez ponownego czytania całej rozmowy. Przy każdej pozycji warto zapisać pięć rzeczy: link do rozmowy, cytowane zdanie lub zdania, artykuł albo procedurę, z którymi je porównano, wersję karty oraz to, kto ocenił: recenzent czy automatyczny system oceny.
Dowody decydują o tym, kto działa. Niezaliczona pozycja w rozmowie konsultanta trafia do coachingu. Niezaliczona pozycja w rozmowie agenta AI trafia do osoby odpowiedzialnej za prompt, artykuł pomocy lub ustawienie, z którego agent skorzystał, a nigdy do konsultanta, który przejął rozmowę. W kartach oceny Kaizo AutoPilot ocenia każdą rozmowę w chwili jej rozwiązania, dołącza komentarz wyjaśniający wynik i łączy każdą ocenę z dowodami w rozmowie.
Przykład: jedna rozmowa konsultanta i jedna agenta AI
Dwie rozmowy z tej samej kolejki rozliczeń, ocenione według powyższej karty. Szczegóły są wymyślone, aby pokazać obliczenia; to nie są dane klienta.
| Kryterium | Rozmowa A: konsultant, zmiana planu, bez przekazania | Rozmowa B: agent AI, prośba o zwrot, przekazana człowiekowi |
|---|---|---|
| 1 Poprawna odpowiedź (20) | 20: nowa cena i data startu zgodne z cennikiem | 0: „Może Pan zwrócić produkt w ciągu 30 dni z pełnym zwrotem pieniędzy.” Zasady zwrotów v3 mówią o 14 dniach dla otwartych produktów |
| 2 Pełna odpowiedź (10) | 10 | 10 |
| 3 Zgodność z procedurami (15) | 15 | 0: pełny zwrot obiecany za otwarty produkt |
| 4 Jasny kolejny krok (10) | 0: kończy się na „sprawdzę to” bez terminu i kanału | 10: informuje klienta, że w tym czacie przejmie go współpracownik |
| 5 Ton dopasowany do sytuacji (5) | 5 | 5 |
| 6 Przekazanie rozmowy (10) | N/A | 0: numer zamówienia przekazany, ale w notatce brak obietnicy zwrotu |
| 7 do 9 Pozycje agenta AI (15) | N/A | 10: w zakresie i eskalacja na prośbę (10); oparcie na treściach niezaliczone (0), żaden artykuł nie mówi o 30 dniach |
| 10 Notatki i tagi (8) | 0: brak notatki o zmianie planu | N/A |
| 11 Dotrzymane działanie następcze (7) | 7: e-mail z potwierdzeniem wysłany tego samego dnia | N/A |
| Punkty zdobyte / dostępne | 57 / 75 | 35 / 85 |
| Wynik | 76% | 41% |
| Błąd krytyczny | Brak | Zwrot obiecany poza procedurami |
| Trafia do | Coaching w zakresie kolejnych kroków i notatek | Osoba odpowiedzialna za artykuł o zwrotach i instrukcje zwrotów agenta AI |
Rozmowa B jest raportowana jako 41% z flagą błędu krytycznego, a nie zamieniana w jedno zero. Konsultant, który przejął rozmowę, jest oceniany za to, jak poradził sobie z wycofaniem obietnicy, w ramach własnej rozmowy, więc błąd agenta AI nigdy nie trafia do jego wyniku. Na samych wspólnych pozycjach A zdobywa 50 z 60, a B 25 z 70, i to te liczby służą do porównania obu stron według tematów.
Wagi i obliczanie wyniku karty oceny
To wagi zamieniają checklistę (po angielsku) w wynik, który coś znaczy. Kilka zasad:
- Ważyć według wpływu. Kryteria wpływające na rozwiązanie sprawy i zgodność powinny ważyć więcej niż kosmetyczne.
- Trzymać się prostej skali. Tak/nie łatwo stosować spójnie; skalę od 1 do 5 warto stosować tylko tam, gdzie niuans naprawdę ma znaczenie.
- Normalizować do 100. Ogólny wynik procentowy łatwo śledzić w czasie i porównywać między zespołami.
- Nie przeceniać subiektywności. Im bardziej kryterium zależy od opinii recenzenta, tym więcej wymaga kalibracji.
Opublikowane karty się nie zgadzają i właśnie o to chodzi
Nie istnieje branżowy standard wag, a dostawcy, którzy publikują swoje, nie są zgodni. Balto przypisuje wagi sekcjom: powitanie 10%, komunikacja 25%, zgodność 20%, rozwiązanie 25%, zakończenie 20%. VereQuest publikuje 100-punktową kartę zachowań, która daje 20 punktów za rozwiązywanie problemów, 15 za empatię i 15 za odpowiedzialność za sprawę (ownership), przy czym powitanie to 5, a użycie imienia klienta 2. Five9 waży rezultaty zamiast zachowań: CSAT 30%, FCR 25%, wynik QA 20%, AHT 15%, przestrzeganie harmonogramu 10%.
Balto przyznaje trzydzieści punktów na sto temu, jak rozmowa się zaczyna i kończy. Nasze karty dla kanałów powyżej nie dają za to prawie nic. Żadne z tych podejść nie jest błędne. Wagi to decyzja biznesowa, a nie dobra praktyka do skopiowania, więc trzeba wyprowadzić własne:
- Zacząć od tego, co naprawdę idzie źle. Wziąć ostatnie 50 eskalacji, zwrotów i reklamacji i przy każdej oznaczyć zachowanie, które by jej zapobiegło. Jeśli 30 z nich wynika z błędnych informacji podanych z pewnością siebie, poprawność zasługuje na więcej niż 5 punktów.
- Sprawdzić, czy wagi cokolwiek przewidują. Ocenić 100 rozmów, a potem zestawić wyniki poszczególnych sekcji z CSAT lub z rozwiązaniem sprawy w tych samych rozmowach. Jeśli wynik za ton nie ma żadnego związku z tym, czy klient był zadowolony, nie powinien ważyć 20 punktów. To pół dnia pracy w arkuszu kalkulacyjnym, a prawie nikt tego nie robi.
Pułapka N/A, która po cichu psuje większość kart
Jeśli kryterium nie dotyczy danej rozmowy, jego punkty trzeba usunąć z mianownika. Nie oceniać go na zero i nie zostawiać go po cichu w sumie.
Arytmetyka ma tu większe znaczenie, niż się wydaje. Konsultant zdobywa 68 punktów na karcie, na której 20-punktowe kryterium faktycznie nie miało zastosowania. Dzieląc przez pomniejszoną sumę, otrzymujemy 68 z 80, czyli 85%. Dzieląc przez pierwotne 100, otrzymujemy 68%. To różnica 17 punktów wynikająca wyłącznie z wyboru sposobu liczenia.
VereQuest opisuje to wprost, zaznaczając, że przy użyciu N/A “the total % or total # of points is reduced by that amount” (łączny % lub łączna liczba punktów zmniejsza się o tę wartość). Warto sprawdzić, co domyślnie robi Państwa narzędzie, bo nie wszystkie robią to poprawnie. Ogólną postać wzoru podaje internal quality score Zendesk: suma ocen podzielona przez maksymalny dostępny wynik we wszystkich kategoriach. Kluczowe słowo to dostępny, a nie możliwy.
Kryteria błędów krytycznych
Niektóre uchybienia są na tyle poważne, że rozmowa powinna zostać oceniona negatywnie mimo dobrego wyniku w pozostałych obszarach. Typowe błędy krytyczne to pominięta weryfikacja tożsamości, pominięta informacja wymagana prawem, podanie błędnych informacji podlegających regulacjom albo poważne nadużycie zaufania klienta. Jasne zdefiniowanie błędów krytycznych sprawia, że karta pozostaje uczciwa: rozmowa, która spełnia wszystkie kryteria komunikacji, ale narusza zgodność, nie jest dobrą rozmową, i wynik powinien to pokazać.
MaestroQA wyróżnia trzy uzasadnione kategorie: naruszenia zgodności i bezpieczeństwa, takie jak ujawnienie danych karty płatniczej czy pominięcie weryfikacji, świadome podanie błędnych informacji oraz obraźliwe zachowanie. Trzy zasady sprawiają, że błędy krytyczne nie niszczą programu:
- Ograniczyć listę do pięciu. Jeśli wszystko jest krytyczne, nic nie jest.
- Każdy błąd krytyczny musi być obiektywnie weryfikowalny. Żaden nie powinien zależeć od oceny tonu przez recenzenta. Ton się ocenia; nigdy nie jest błędem krytycznym.
- Raportować błędy krytyczne oddzielnie od wyniku. Konsultant z jednym błędem krytycznym i dziewiętnastoma mocnymi rozmowami to inny problem niż konsultant ze średnią 60%. Połączenie ich w jedną średnią kroczącą ukrywa oba, a jedno zero w miesiącu z pięcioma rozmowami samo obniża średnią o 20 punktów.
Jaki wynik QA jest dobry?
Nie istnieje uniwersalny próg zaliczenia, bo zależy on od tego, jak wymagająca jest Państwa karta. Większość dojrzałych programów wyznacza przedział docelowy, często około 85 do 90% i więcej, a wyniki poniżej traktuje jako sygnał do coachingu. Dwie rzeczy liczą się bardziej niż sama liczba: kryteria błędów krytycznych, które mają nad nią pierwszeństwo, oraz trend dla konsultanta i zespołu w czasie, zwłaszcza to, czy koreluje z CSAT. Pojedynczy wynik mówi niewiele; rosnący trend, który idzie w parze z bardziej zadowolonymi klientami, mówi wszystko.
Jest też twardszy powód, by nie przywiązywać się do samej liczby, i jest to kwestia arytmetyki, a nie filozofii.
Ile rozmów należy oceniać?
Jeśli celem jest coaching, wystarczy ocenić od 5 do 10 rozmów na konsultanta miesięcznie i traktować wynik jako wskazówkę, a nie ranking. Przy pięciu ocenach margines błędu odsetka zaliczeń konsultanta wynosi około 26 punktów przy 95% poziomie ufności, więc ranking konsultantów albo uzależnienie od wyniku wynagrodzenia wymaga znacznie większych próbek lub oceny każdej rozmowy.
Opublikowane zalecenia różnią się ponad dziesięciokrotnie i żadnego z nich nie da się pogodzić z pozostałymi.
Call Centre Helper zaleca 5 do 6 rozmów na konsultanta, a Garry Gormley z FAB Solutions nazywa to optymalnym punktem między sprawiedliwością a kosztem zasobów. HiveDesk zaleca 5 do 10 na konsultanta miesięcznie, a dla nowych pracowników w pierwszych 90 dniach od 10 do 15. OttoQA opowiada się za około 65 na konsultanta miesięcznie, choć to argument dostawcy oparty na agresywnych założeniach co do wolumenu, bez żadnych źródeł. C2Perform podaje właściwe parametry statystyczne, 95% poziomu ufności i 5% marginesu błędu przy Z = 1,96, ale nigdy nie pokazuje wzoru.
Oto więc obliczenia. Każdą ocenioną rozmowę traktujemy jako zaliczoną lub niezaliczoną względem Państwa standardu jakości. Margines błędu dla rzeczywistego odsetka zaliczeń konsultanta przy 95% poziomie ufności, przy założeniu, że ten odsetek naprawdę wynosi 90%:
| Liczba ocenionych rozmów na konsultanta | Margines błędu |
|---|---|
| 5 | plus minus 26,3 punktu |
| 10 | plus minus 18,6 punktu |
| 25 | plus minus 11,8 punktu |
| 50 | plus minus 8,3 punktu |
| 100 | plus minus 5,9 punktu |
Te wartości są obliczone, a nie zaczerpnięte ze źródeł: 1,96 pomnożone przez pierwiastek kwadratowy z p(1-p)/n. Traktowanie sumy z karty jako dwumianowego odsetka zaliczeń to uproszczenie, i to celowe.
Konsultant oceniony pięć razy, który uzyskał 85%, ma rzeczywisty poziom jakości gdzieś między mniej więcej 59% a 100%. Nie da się go odróżnić od kolegi, który uzyskał 95%. Aby zawęzić margines do plus minus 5 punktów, potrzeba około 139 ocen na konsultanta miesięcznie.
Co z tym zrobić, uczciwie:
- Nie tworzyć rankingów konsultantów na małych próbkach i nie uzależniać wynagrodzenia od średniej z pięciu rozmów. Pomiar tego nie udźwignie.
- Używać małych próbek do coachingu. Pięć ocen nie powie, że konsultant jest w najsłabszym decylu, ale pokaże, że ten konsultant pomija weryfikację. Znalezienie konkretnego zachowania do poprawy wymaga znacznie mniej danych niż tworzenie rankingu ludzi.
- Agregować w górę. Pięć ocen na konsultanta w 40-osobowym zespole to 200 punktów danych na poziomie zespołu, w zupełności wystarczająco, by wychwycić problem z procesem lub procedurą.
- Zwiększać próbkę tam, gdzie stawka jest wysoka: przy nowych pracownikach, rozmowach podlegających regulacjom i osobach, których wyniki są formalnie kwestionowane.
Automatyczna ocena każdej rozmowy usuwa ten problem, bo nie zostaje żadna próbka, która mogłaby być niereprezentatywna. Wprowadza za to inne ryzyka, omówione niżej.
Kalibracja: sprawiedliwe wyniki
To kalibracja sprawia, że karcie oceny można zaufać. Podczas sesji kalibracyjnej kilku recenzentów, a coraz częściej także AI, niezależnie ocenia te same rozmowy, a następnie porównuje i uzgadnia różnice. Ujawnia to niejasne kryteria, ujednolica interpretację i buduje wspólny standard, dzięki któremu konsultanci akceptują swoje wyniki. Bez kalibracji „wynik” to tylko opinia jednej osoby. Z kalibracją karta staje się sprawiedliwą, spójną miarą, i o to właśnie chodzi.
Większość poradników na tym się kończy, nie mówiąc, jak wygląda udana kalibracja. Warto przypisać jej liczby. Co miesiąc od trzech do pięciu recenzentów niezależnie ocenia te same sześć rozmów, bez dyskusji, a następnie mierzy dwie rzeczy.
Rozrzut wyników. Różnica między najwyższą a najniższą sumą dla tej samej rozmowy. Praktyczny próg roboczy to 10 punktów na karcie 100-punktowej. Większy rozrzut oznacza, że definicje kryteriów są niejasne, a nie że któryś recenzent się myli.
Zgodność dla każdego kryterium. Trzeba ustalić, przy których konkretnych kryteriach recenzenci się nie zgadzają. Prawie nigdy nie są to kryteria zero-jedynkowe. Są to skale oceny z niezdefiniowanymi punktami. Jeśli potrzebna jest formalna miara, kappa Cohena koryguje zgodność o przypadek, a standardowe przedziały Landisa i Kocha określają 0,41 do 0,60 jako zgodność umiarkowaną, 0,61 do 0,80 jako znaczną i 0,81 do 1,00 jako niemal doskonałą (podsumowanie tutaj). Warto celować w 0,61 lub więcej przy każdym kryterium o realnej wadze. Poniżej 0,41 kryterium mierzy recenzenta, a nie konsultanta.
Poprawiać kartę, nie recenzenta. Gdy kalibracja wykaże rozbieżności, trzeba przepisać definicję kryterium. Prośba, by recenzenci bardziej się starali, nie przetrwa zderzenia z kolejną niejednoznaczną rozmową.
Jak to wygląda z perspektywy konsultanta
Karty oceny projektują menedżerowie, a doświadczają ich konsultanci, i to w przepaści między tymi dwiema perspektywami programy jakości po cichu upadają. Konsultanci obsługi klienta publicznie i szczegółowo opisują swoje programy, a te same wzorce się powtarzają.
Próbkowanie wygląda na loterię, bo przy takich próbkach częściowo nią jest. Jeden konsultant opisuje, że dobrze radzi sobie z typami rozmów, w których jest najmocniejszy, a potem: “I followed my call flow to perfection on my new bookings and yet, they didn’t pull those.” (w tłumaczeniu: „Przy nowych rezerwacjach perfekcyjnie trzymałem się scenariusza rozmowy, a mimo to tych nie wybrali”). (r/callcentres) To nie paranoja. To margines błędu rzędu 26 punktów odczuwany od środka.
Nierówne próbki niszczą porównanie. Z wątku o automatycznej kontroli jakości: “This means my score might be based on 20 calls and my coworkers is based on 34.” („To znaczy, że mój wynik może opierać się na 20 rozmowach, a wynik kolegi na 34”). (r/callcentres) Jeśli w ogóle tworzą Państwo rankingi konsultantów, wielkość próbki musi być stała.
Jedno niezależne od konsultanta zdarzenie może zrujnować średnią kroczącą. “My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100.” („Mój pies zaszczekał (rzadko to robi) i dostałem zero za rozmowę, która poza tym byłaby idealną setką”). (r/callcentres) To problem uśredniania błędów krytycznych w praktyce.
Kryteria, które ignorują powód kontaktu, wyglądają na pracę dla samej pracy. Jeden z konsultantów o ocenianiu budowania relacji: “I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment.” („Pracuję u sprzedawcy energii, nie muszę zabierać nikogo w podróż, kiedy chce tylko dokonać płatności”). Jeśli karta stosuje te same kryteria do resetu hasła i do zgłoszenia śmierci bliskiej osoby, będzie budzić niechęć i będzie mierzyć niewłaściwe rzeczy. Warto stosować karty dla konkretnych kanałów lub typów kontaktu albo poprawnie używać N/A.
Błędy recenzentów bez możliwości korekty zatruwają cały program. “3 of the 4 things that they said I didn’t ask, I absolutely did.” („O 3 z 4 rzeczy, o które rzekomo nie zapytałem, na pewno zapytałem”). (r/callcentres)
Rozwiązanie pojawia się w tym samym wątku, opisane przez analityka QA, którego program działa. Przesyłają sobie nawzajem rozmowy “to make sure we’re being fair and accurate” („żeby upewnić się, że jesteśmy sprawiedliwi i dokładni”), konsultanci mogą zakwestionować każdy wynik, a gdy zespół QA się myli, “own up to it and award the points back” („przyznaje się do tego i oddaje punkty”). To kalibracja plus procedura odwoławcza, i to właśnie odróżnia kartę, której ludzie ufają, od takiej, którą jedynie znoszą.
Dlatego odwołania trzeba wbudować w proces. Konsultant powinien otrzymać ocenioną rozmowę, rozbicie wyniku na kryteria, termin na odwołanie i wskazaną z nazwiska osobę, która decyduje. Warto śledzić odsetek zmienionych ocen. Jeśli jest bliski zeru, konsultanci prawdopodobnie przestali się odwoływać. Jeśli przekracza mniej więcej 10%, karta jest niejednoznaczna.
Najczęstsze błędy w kartach oceny rozmów
- Zbyt wiele kryteriów. Przeładowana karta rozmywa istotny sygnał i spowalnia ocenę.
- Niejasne sformułowania. Subiektywne kryteria dają niespójne wyniki i opór konsultantów.
- Brak wag. Traktowanie wszystkich kryteriów jednakowo ukrywa to, co naprawdę ważne.
- Brak błędów krytycznych. Przepuszczanie naruszenia zgodności, bo reszta wypadła dobrze.
- Ustawić i zapomnieć. Karta, której nikt nie aktualizuje, rozmija się z potrzebami firmy.
Ręczna i automatyczna ocena według karty
Karta oceny jest tak użyteczna, jak Państwa możliwość jej stosowania. Przy ocenie ręcznej nawet świetna karta obejmuje tylko próbkę, często od 5 do 10 rozmów na konsultanta miesięcznie. Przy ocenie przez AI, jak w przypadku kart oceny Kaizo, ta sama karta jest stosowana do każdej rozmowy, prowadzonej przez człowieka lub AI, w spójny sposób, a recenzenci mogą zająć się kalibracją i coachingiem.
| Ocena ręczna | Ocena automatyczna | |
|---|---|---|
| Pokrycie | Próbka na konsultanta | 100% rozmów |
| Spójność | Zależy od recenzenta i dnia | Jeden spójny standard |
| Nakład pracy | Godziny oceniania co tydzień | Przeniesiony na coaching |
Proszę zobaczyć, jak automatyczna kontrola jakości stosuje Państwa kartę do każdej rozmowy i jak Coaching AI zamienia wyniki w rozwój konsultantów.
Jak to wygląda w praktyce, pokazują dwa zespoły. W UiPath Kaizo zautomatyzowało 100% kontroli jakości, przy 200% ROI i wzroście wyniku jakości o 8%. SteelSeries skróciło czas kontroli jakości o połowę dzięki podsumowaniom AI przy długich, technicznych zgłoszeniach.
Jedna karta oceny dla obu stron. Kaizo ocenia każdą rozmowę w obsłudze klienta, prowadzoną przez człowieka lub AI, według Państwa własnej karty oceny i łączy każdą ocenę z dowodami, na których się opiera. Umów demo.
Kiedy ta karta oceny nie jest dla Państwa
Pełna ważona karta z dowodami przy każdej pozycji to więcej, niż potrzebują niektóre zespoły. Jeśli obsługują Państwo kilkadziesiąt rozmów tygodniowo, wystarczy czytać je samodzielnie z krótką checklistą; karta zaczyna się opłacać, gdy nie da się już przeczytać wszystkiego. Jeśli nie mają Państwo jeszcze agenta AI, wystarczy usunąć pozycje od 7 do 9 i błąd krytyczny dla agenta AI, a szablon działa jak zwykła karta dla konsultantów. Jeśli procedury i artykuły pomocy nie są spisane, trzeba je najpierw spisać: „poprawnej odpowiedzi” i „zgodności z procedurami” nie da się ocenić względem standardu, który istnieje tylko w głowach ludzi. A jeśli potrzebny jest zestaw testów agenta AI przed uruchomieniem, na przykład testy regresji promptów, to inny etap i inny rodzaj narzędzia niż ocena zakończonych rozmów.
Wersjonowanie karty oceny
Karta oceny będzie się zmieniać, a każda zmiana przerywa Państwa własną linię trendu. Wyniki sprzed zmiany i po niej nie są porównywalne, a prawie nikt o tym nie ostrzega.
Wystarczą trzy praktyki. Nadawać karcie numer wersji i oznaczać każdą ocenę wersją, której użyto. Nigdy nie zmieniać wag w połowie kwartału. Przy zmianie ponownie ocenić 20 zarchiwizowanych rozmów według starej i nowej karty, aby poznać skalę przesunięcia, a następnie zaznaczyć zmianę na każdym wykresie, który ją obejmuje.
Dwa razy w roku warto przejrzeć kartę pod kątem aktualnych powodów eskalacji. Kryteria, które miały sens dwa produkty temu, zwykle utrzymują się znacznie dłużej, niż powinny.
Podsumowanie
Karta oceny rozmów to najważniejsze narzędzie programu jakości. Powinna być skupiona na tym, co istotne, ważona według wpływu, mieć zdefiniowane błędy krytyczne, być kalibrowana i aktualizowana wraz ze zmianami w firmie. Następnie warto stosować ją do 100% rozmów, prowadzonych przez ludzi i przez AI, dzięki automatyzacji, aby standard, którego zdefiniowanie wymagało tyle pracy, naprawdę obejmował każdą interakcję, a nie tylko próbkę. Tak karta przestaje być checklistą i staje się motorem spójnej jakości.
Najczęściej zadawane pytania
Jak obliczyć wynik QA?
Należy zsumować zdobyte punkty i podzielić je przez punkty faktycznie dostępne w danej rozmowie, a nie przez nominalną sumę karty. Jeśli 20-punktowe kryterium nie miało zastosowania, mianownik wynosi 80, a nie 100. Konsultant z 68 punktami uzyskuje 85% przy poprawnej metodzie i 68% przy błędnej.
Jak poprawić niski wynik QA?
Trzeba patrzeć na dane dla poszczególnych kryteriów, a nie na sumę. 72% wynikające z systematycznego pomijania weryfikacji to poprawka na dziesięć minut. Te same 72% rozłożone równo na wszystkie kryteria to zupełnie inny problem. Jeśli nie widać, które kryteria obniżają wynik, w pierwszej kolejności trzeba poprawić raportowanie.
Jak stworzyć checklistę QA?
Zacząć od ostatnich 50 eskalacji i zwrotów, przy każdej oznaczyć zachowanie, które by jej zapobiegło, i pozwolić, by częstotliwość wyznaczyła kryteria. Ograniczyć listę do 20 pozycji i dla każdego punktu skali napisać definicję w jednym zdaniu.
Ile kryteriów powinna mieć karta oceny rozmów?
Mniej, niż się wydaje. Warto zostawić kryteria, które przewidują rezultaty dla klienta, i ograniczyć błędy krytyczne do pięciu. Przeładowana karta rozmywa sygnał, spowalnia ocenę i wymaga więcej kalibracji przy każdej dodatkowej ocenie subiektywnej.
Czy jedna karta oceny może służyć agentom AI i konsultantom?
Tak, w zakresie kryteriów opisujących rezultat dla klienta: poprawna i pełna odpowiedź, zgodność z procedurami, jasny kolejny krok i sprawne przekazanie rozmowy. Do tego dochodzi kilka pozycji dotyczących tylko jednej strony, na przykład oparcie na Państwa treściach dla agenta AI i notatki dla konsultantów, a pozycje drugiej strony oznacza się jako N/A. Obie strony porównuje się tylko na wspólnych pozycjach.
Kto poprawia niezaliczoną pozycję w rozmowie agenta AI?
Osoba odpowiedzialna za to, z czego agent AI skorzystał: prompt, artykuł pomocy, treść procedury lub ustawienie. Dlatego każda niezaliczona pozycja powinna zapisywać źródło, z którym ją porównano. Konsultant, który przejął rozmowę, jest oceniany tylko za własne działania.
Czy kartę oceny można stosować automatycznie?
Tak. Automatyczna kontrola jakości stosuje Państwa kartę do każdej rozmowy, prowadzonej przez człowieka lub AI, w spójny sposób, a ludzie zajmują się kalibracją, odwołaniami i coachingiem. W Kaizo AutoPilot ocenia każdą rozmowę w chwili jej rozwiązania i łączy każdą ocenę z dowodami w rozmowie.
Czy potrzebne są osobne karty dla czatu, e-maila i telefonu?
Zwykle tak, a przynajmniej inne wagi. Główne kategorie pozostają te same, ale kryteria takie jak tempo odpowiedzi czy prowadzenie rozmowy telefonicznej są specyficzne dla kanału.
Źródła
- Zendesk, wzór internal quality score
- Balto, wagi sekcji
- VereQuest, 100-punktowa karta zachowań i obsługa N/A
- Five9, wagi rezultatów i częstotliwość kalibracji
- MaestroQA, kategorie błędów krytycznych
- Call Centre Helper, wielkość próbki
- HiveDesk, wielkość próbki według stażu
- OttoQA, liczba ocen na konsultanta (twierdzenie dostawcy, bez źródeł)
- C2Perform, parametry ufności
- Przedziały interpretacji kappa według Landisa i Kocha
Wartości marginesu błędu na tej stronie są obliczone, a nie zaczerpnięte ze źródeł, i są tak oznaczone tam, gdzie się pojawiają. Cytaty praktyków pochodzą z publicznych wątków r/callcentres, podlinkowanych w tekście, i są podane w oryginale angielskim wraz z tłumaczeniem.
Powiązane artykuły
- 5 bezpłatnych szablonów kart oceny (po angielsku)
- Kryteria błędów krytycznych w QA (po angielsku)
- Jak zapisać pozycje karty oceny, które AI naprawdę oceni (po angielsku)
- Kalibracja QA: sesje, które eliminują stronniczość ocen (po angielsku)
Proszę stosować kartę oceny rozmów w 100% przypadków
Proszę umówić 30-minutowe demo i zobaczyć, jak Kaizo ocenia każdą rozmowę, prowadzoną przez człowieka lub AI, według Państwa karty i zamienia wyniki w coaching.






