
Une grille d’évaluation QA, qu’il s’agisse d’une grille d’évaluation d’appel téléphonique, de chat ou d’e-mail, est une liste pondérée de critères qui sert à noter chaque conversation client, avec quelques critères éliminatoires pour les manquements qui suffisent à faire échouer un échange. Elle transforme le « bon service » en lignes que deux évaluateurs, ou une IA, notent de la même façon, et le total devient la note qualité qui alimente le coaching et le reporting. Vous trouverez ci-dessous un modèle à copier qui note les conversations des conseillers et des agents IA sur une même grille, avec les calculs de pondération, de N/A et d’échantillon que la plupart des guides laissent de côté.
En bref
- Une grille d’évaluation QA compte cinq éléments : des critères, des pondérations, une échelle de notation, des critères éliminatoires et la trace des preuves derrière chaque note.
- Les grilles publiées pondèrent les mêmes sections de façon très différente : déduisez vos poids de vos propres escalades et vérifiez qu’ils prédisent le CSAT.
- Quand un critère ne s’applique pas, retirez ses points du dénominateur : le noter zéro peut déplacer un résultat de 17 points.
- Avec cinq évaluations par conseiller, la marge d’erreur sur un taux de réussite est d’environ 26 points, assez pour coacher mais pas pour classer les personnes.
- Quand conseillers et agents IA partagent une file, une seule grille avec des critères communs, des lignes propres à chaque intervenant et des critères éliminatoires par intervenant garde les deux au même standard.
Qu’est-ce qu’une grille d’évaluation QA ?
Une grille d’évaluation QA est une liste structurée de critères pondérés qui sert à évaluer la qualité d’une conversation de service client. Chaque critère décrit une partie de ce qu’est un bon échange, et chaque conversation est notée au regard de ces critères pour obtenir une note qualité globale, qui alimente le coaching et le reporting.
La grille, c’est la définition de la qualité rendue concrète. Au lieu d’une vague impression qu’une conversation était « bonne », la grille découpe la qualité en éléments précis et mesurables (la demande a-t-elle été résolue, le ton était-il juste, la procédure a-t-elle été respectée) et attribue un poids à chacun. C’est ce qui rend le contrôle qualité homogène, exploitable pour le coaching et défendable.
La grille d’évaluation est l’instrument complet : critères, pondérations, échelle et critères éliminatoires. Les consignes détaillées sur ce qui vaut chaque niveau de note forment ce qu’on appelle une grille de critères qualité, et une bonne grille d’évaluation porte ces consignes pour chaque critère, afin que les évaluateurs et l’IA lisent chaque ligne de la même façon.
Pourquoi la grille d’évaluation QA compte
C’est sur la grille que la plupart des programmes QA réussissent ou échouent. Une bonne grille :
- Crée de l’homogénéité, pour que chaque évaluateur, et chaque évaluation par l’IA, note selon le même standard.
- Rend le feedback précis, pour que les conseillers sachent exactement quoi améliorer, et pas seulement leur note globale.
- Aligne la qualité sur les résultats, en notant les comportements qui font réellement progresser le CSAT et la résolution.
- Résiste à l’examen, quand un conseiller conteste une note ou qu’un régulateur demande des preuves.
Une grille surchargée ou floue produit l’inverse : la QA devient un exercice subjectif de cases à cocher, dont les conseillers se méfient et dont les managers ne peuvent rien tirer.
Ce que contient une bonne grille d’évaluation QA
Toute grille efficace partage quelques ingrédients :
- Des critères clairs, rédigés comme des questions objectives auxquelles on peut répondre.
- Des pondérations qui reflètent l’importance de chaque critère pour votre activité.
- Une échelle de notation, souvent oui/non, ou de 1 à 5 pour les critères plus nuancés.
- Des critères éliminatoires (auto-fail) pour les comportements critiques en matière de conformité.
- Des sections ou catégories qui regroupent les critères liés pour un reporting lisible.
Catégories et critères d’une grille d’évaluation QA
La plupart des grilles d’évaluation QA du service client organisent leurs critères en quatre catégories :
| Catégorie | Exemples de critères |
|---|---|
| Résolution | La demande a-t-elle été entièrement résolue ? L’information était-elle exacte ? La bonne solution a-t-elle été proposée ? |
| Conformité | Le client a-t-il été vérifié ? Les mentions obligatoires ont-elles été données ? La procédure a-t-elle été respectée ? |
| Communication | Le ton était-il empathique et professionnel ? La réponse était-elle claire ? La préoccupation du client a-t-elle été prise en compte ? |
| Efficacité | La demande a-t-elle été traitée sans transferts, répétitions ou délais inutiles ? |
Exemples par canal, dont la grille d’évaluation d’appel téléphonique
Une grille doit s’adapter au canal. Voici des exemples simplifiés.
Grille d’évaluation QA chat et messagerie
| Critère | Poids |
|---|---|
| Demande résolue avec exactitude | 30 % |
| Temps de réponse et rythme adaptés | 15 % |
| Messages clairs, bien mis en forme et empathiques | 25 % |
| Bonne procédure et vérification respectées | 20 % |
| Clôture correcte et prochaines étapes | 10 % |
Grille d’évaluation QA e-mail et ticket
| Critère | Poids |
|---|---|
| Résolution complète et exacte en un minimum de réponses | 35 % |
| Ton professionnel, conforme à la marque, et grammaire soignée | 25 % |
| Conformité et procédures respectées | 25 % |
| Structure claire et prochaines étapes | 15 % |
Grille d’évaluation QA appel téléphonique
| Critère | Poids |
|---|---|
| Demande résolue, information correcte | 30 % |
| Vérification d’identité et conformité | 25 % |
| Empathie, écoute active, ton | 25 % |
| Maîtrise de l’appel et efficacité | 20 % |
Comment construire une grille d’évaluation QA
- Partez de votre définition de la qualité. Listez ce qu’est une excellente conversation pour votre équipe, puis regroupez ces éléments en catégories.
- Rédigez des critères objectifs. Formulez chacun comme une question claire à laquelle un évaluateur ou une IA peut répondre de façon homogène. Évitez les termes flous comme « bon service ».
- Attribuez des pondérations. Donnez plus de poids à ce qui détermine les résultats client. La résolution et la conformité pèsent généralement le plus.
- Définissez les critères éliminatoires. Décidez quels manquements font échouer toute la conversation, quel que soit le reste.
- Testez et calibrez. Évaluez un lot avec votre équipe, comparez les résultats et affinez la formulation jusqu’à ce que la notation soit homogène.
- Révisez régulièrement. Mettez la grille à jour à mesure que les produits, les procédures et les besoins des clients évoluent.
Modèle gratuit de grille d’évaluation QA
Le modèle de la section suivante est celui à copier si conseillers et agents IA répondent dans les mêmes files. S’il vous faut seulement une grille pour un canal, chat, e-mail, téléphone ou réclamations, partez de nos cinq grilles prêtes à l’emploi par canal (en anglais) et ajustez les poids.
Modèle de grille d’évaluation QA pour conseillers et agents IA
Une grille d’évaluation QA pour conseillers et agents IA est une seule grille en trois parties : des critères communs qui notent chaque conversation de la même façon, quelques lignes propres à l’agent IA ou au conseiller, et des critères éliminatoires par intervenant. Chaque ligne notée garde sa preuve, pour que chacun puisse vérifier pourquoi elle est conforme ou non.
Copiez le tableau dans un tableur ou dans votre outil QA. Les points sont un exemple : adaptez-les à vos propres escalades, comme expliqué plus bas dans la partie sur la pondération. Notez chaque ligne au maximum de ses points ou à zéro, et marquez-la N/A quand elle ne s’applique pas.
| # | Critère | S’applique à | Conforme quand | Points | Preuve à consigner |
|---|---|---|---|---|---|
| 1 | Réponse exacte | Les deux | Chaque information est juste pour le cas de ce client | 20 | La ligne qui donne l’information, et l’article ou la règle auquel elle doit correspondre |
| 2 | Réponse complète | Les deux | Chaque partie de la question reçoit une réponse, conditions comprises | 10 | La partie de la question restée sans réponse |
| 3 | Règles respectées | Les deux | Rien n’est proposé, promis ou refusé en dehors des règles écrites | 15 | L’offre ou le refus, et la règle (avec sa version) qu’il enfreint |
| 4 | Prochaine étape claire | Les deux | Le client sait ce qui va se passer, ou la demande est résolue | 10 | Le message de clôture |
| 5 | Ton adapté à la situation | Les deux | La réponse correspond à votre marque et à l’état du client | 5 | La ligne en cause, citée |
| 6 | Transfert | Les deux, N/A sans transfert | Le contexte est transmis lors d’un transfert, et celui qui reprend s’en sert | 10 | La note de transfert et la première réponse de celui qui reprend |
| 7 | Appuyé sur vos contenus | Agent IA uniquement | Chaque information vient d’un article d’aide ou d’une règle que vous publiez | 5 | L’article utilisé, ou « aucune source trouvée » |
| 8 | Reste dans son périmètre | Agent IA uniquement | Il ne traite que les sujets et les actions qui lui sont permis | 5 | La demande hors périmètre et la réponse |
| 9 | Transfère ou reconnaît son incertitude | Agent IA uniquement | Il passe la main sur les déclencheurs définis et ne devine pas | 5 | La ligne déclencheuse et ce que l’agent IA a fait ensuite |
| 10 | Notes et tags du dossier | Conseiller uniquement | La personne suivante peut reprendre sans redemander au client | 8 | La note ou le tag manquant |
| 11 | Suivi tenu | Conseiller uniquement, N/A sans promesse | Un rappel ou une mise à jour promis a eu lieu à temps | 7 | La promesse et la date à laquelle elle a été tenue ou non |
La grille totalise 100 points : 70 communs, 15 pour l’agent IA et 15 pour les conseillers. Sur une conversation donnée, les lignes de l’autre intervenant sont N/A : une conversation peut donc obtenir au maximum 85 points, ou 75 sans transfert. Divisez par les points disponibles, exactement comme avec la règle du N/A expliquée plus bas, et chaque conversation garde un seul pourcentage.
Comparez conseillers et agents IA sur les lignes communes uniquement, sujet par sujet, car l’agent IA reçoit en général les sujets les plus simples. Notre guide sur la grille d’évaluation commune aux conseillers et aux agents IA montre cette comparaison sur un exemple chiffré, ainsi que l’option de garder les lignes propres à chaque intervenant en conforme ou non conforme à côté de la note, plutôt qu’en points. Pour comprendre pourquoi les lignes réservées à l’IA existent, et quels critères humains retirer pour un bot, lisez notre guide sur la grille d’évaluation d’un agent IA.
Critères éliminatoires pour conseillers et agents IA
Les critères éliminatoires l’emportent sur la note, quel que soit l’intervenant. Limitez-les à cinq, rendez chacun vérifiable dans la transcription, et suivez-les à côté de la note plutôt qu’à l’intérieur.
| Critère éliminatoire | S’applique à | Comment le vérifier |
|---|---|---|
| Données du compte communiquées avant la vérification d’identité | Les deux | Étape de vérification absente avant la première donnée du compte |
| Remboursement, avoir ou exception promis hors des règles | Les deux | La promesse citée face à la règle écrite |
| Numéro de carte ou mot de passe demandé ou répété dans la conversation | Les deux | La ligne qui contient la donnée |
| Déclencheur de transfert obligatoire ignoré, comme une demande à parler à une personne ou une menace juridique | Agent IA | La ligne déclencheuse et les réponses qui suivent |
| Propos injurieux ou discriminatoires envers le client | Les deux | La ligne citée |
La ligne de l’agent IA est celle que les grilles des conseillers n’ont pas. Un conseiller à qui l’on demande un responsable sait qu’il doit transférer ; un agent IA doit en recevoir la consigne, et quand ses instructions oublient un déclencheur, il fait tourner le client en boucle dans chaque conversation concernée.
Comment consigner les preuves
Chaque ligne notée doit laisser une trace que quelqu’un d’autre peut vérifier sans relire toute la conversation. Conservez cinq éléments par ligne : le lien vers la conversation, la ou les lignes citées, l’article ou la règle de référence, la version de la grille, et qui a noté, un évaluateur ou un outil de notation automatique.
La preuve décide de qui agit. Une ligne non conforme sur la conversation d’un conseiller part en coaching. Une ligne non conforme sur la conversation d’un agent IA part chez la personne responsable du prompt, de l’article d’aide ou du paramètre utilisé, jamais chez le conseiller qui a repris la conversation. Avec les grilles d’évaluation de Kaizo, AutoPilot évalue chaque conversation dès qu’elle est résolue, y joint un commentaire qui explique la note et relie chaque note aux preuves dans la conversation.
Exemple chiffré : une conversation de conseiller et une d’agent IA
Deux conversations de la même file facturation, notées avec la grille ci-dessus. Les détails sont inventés pour montrer le calcul ; ce ne sont pas des données client.
| Critère | Conversation A : conseiller, changement d’offre, sans transfert | Conversation B : agent IA, demande de remboursement, transférée à un conseiller |
|---|---|---|
| 1 Réponse exacte (20) | 20 : le nouveau prix et la date de début correspondent à la grille tarifaire | 0 : « Vous pouvez le retourner sous 30 jours pour un remboursement complet. » La règle de remboursement v3 prévoit 14 jours pour un article ouvert |
| 2 Réponse complète (10) | 10 | 10 |
| 3 Règles respectées (15) | 15 | 0 : remboursement complet promis sur un article ouvert |
| 4 Prochaine étape claire (10) | 0 : se termine sur « Je regarde ça » sans délai ni canal | 10 : indique au client qu’un collègue reprend dans ce chat |
| 5 Ton adapté à la situation (5) | 5 | 5 |
| 6 Transfert (10) | N/A | 0 : numéro de commande transmis, mais la promesse de remboursement manque dans la note |
| 7 à 9 Lignes agent IA (15) | N/A | 10 : dans son périmètre et transfert à la demande (10) ; ancrage non conforme (0), aucun article ne prévoit 30 jours |
| 10 Notes et tags du dossier (8) | 0 : aucune note sur le changement d’offre | N/A |
| 11 Suivi tenu (7) | 7 : e-mail de confirmation envoyé le jour même | N/A |
| Points obtenus / disponibles | 57 / 75 | 35 / 85 |
| Note | 76 % | 41 % |
| Critère éliminatoire | Aucun | Remboursement promis hors des règles |
| Destinataire | Coaching sur les prochaines étapes et les notes du dossier | Le responsable de l’article sur les remboursements et des consignes de remboursement de l’agent IA |
La conversation B est suivie à 41 % avec un signal éliminatoire, pas fondue dans un zéro. Le conseiller qui a repris est noté sur sa propre gestion de la promesse retirée, dans sa propre conversation, si bien que l’erreur de l’agent IA ne pèse jamais sur sa note. Sur les seules lignes communes, A obtient 50 sur 60 et B 25 sur 70 : c’est ce chiffre qu’il faut utiliser pour comparer les deux intervenants par sujet.
Pondérer et noter une grille d’évaluation QA
C’est la pondération qui transforme une checklist (en anglais) en note significative. Quelques principes :
- Pondérez selon l’impact. Les critères qui touchent à la résolution et à la conformité doivent peser plus que les critères cosmétiques.
- Gardez une échelle simple. Le oui/non est facile à appliquer de façon homogène ; n’utilisez une échelle de 1 à 5 que là où la nuance compte vraiment.
- Ramenez sur 100. Un pourcentage global est facile à suivre dans le temps et à comparer entre équipes.
- Ne surpondérez pas le subjectif. Plus un critère dépend de l’avis de l’évaluateur, plus il demande de calibrage.
Les grilles publiées ne sont pas d’accord, et c’est bien le sujet
Il n’existe pas de pondération standard dans le secteur, et les éditeurs qui publient la leur ne sont pas d’accord entre eux. Balto pondère par section : accueil 10 %, communication 25 %, conformité 20 %, résolution 25 %, clôture 20 %. VereQuest publie une grille de comportements sur 100 points qui pondère la résolution de problèmes à 20, l’empathie à 15 et la prise en charge à 15, avec l’accueil à 5 et l’utilisation du nom du client à 2. Five9 pondère les résultats plutôt que les comportements : CSAT 30 %, FCR 25 %, note QA 20 %, AHT 15 %, respect du planning 10 %.
Balto consacre trente points sur cent à la façon dont la conversation commence et se termine. Nos grilles par canal ci-dessus n’y consacrent presque rien. Aucune des deux n’a tort. Les pondérations sont une décision métier, pas une bonne pratique à recopier. Définissez donc les vôtres :
- Partez de ce qui tourne réellement mal. Prenez vos 50 dernières escalades, remboursements et réclamations, et associez à chacun le comportement qui l’aurait évité. Si 30 d’entre eux viennent d’une information fausse donnée avec assurance, l’exactitude mérite plus de 5 points.
- Vérifiez que les pondérations prédisent quelque chose. Évaluez 100 conversations, puis corrélez les notes par section avec le CSAT ou la résolution de ces mêmes conversations. Si votre note de ton n’a aucun lien avec la satisfaction finale du client, elle ne doit pas peser 20 points. C’est une demi-journée dans un tableur, et presque personne ne le fait.
Le piège du N/A qui fausse discrètement la plupart des grilles
Si un critère ne s’applique pas à une conversation, retirez ses points du dénominateur. Ne le notez pas zéro, et ne le laissez pas en place sans rien dire.
Le calcul compte plus qu’il n’y paraît. Un conseiller obtient 68 points sur une grille où un critère de 20 points ne s’appliquait vraiment pas. Diviser par le total réduit donne 68 sur 80, soit 85 %. Diviser par les 100 d’origine donne 68 %. Un écart de 17 points, produit uniquement par un choix comptable.
VereQuest traite ce cas explicitement et précise que lorsque N/A est utilisé, « the total % or total # of points is reduced by that amount » (le pourcentage ou le nombre total de points est réduit d’autant). Vérifiez ce que fait votre outil par défaut, car tous ne le font pas correctement. Pour la forme générale, l’indice de qualité interne de Zendesk est la somme des notes divisée par la note maximale disponible sur l’ensemble des catégories. Le mot important est disponible, pas possible.
Critères éliminatoires (auto-fail)
Certains manquements sont assez graves pour que la conversation échoue, même avec une note par ailleurs solide. Les critères éliminatoires typiques : une vérification d’identité sautée, une mention légale omise, une information réglementée erronée ou une atteinte grave à la confiance du client. Définir explicitement les critères éliminatoires garde votre grille honnête : une conversation qui coche toutes les cases de la communication mais enfreint la conformité n’est pas une bonne conversation, et la note doit le dire.
MaestroQA identifie trois catégories légitimes : les manquements à la conformité et à la sécurité, comme exposer des données de carte ou sauter la vérification, donner sciemment une information fausse, et un comportement injurieux. Trois règles rendent les critères éliminatoires supportables :
- Limitez la liste à cinq. Si tout est critique, rien ne l’est.
- Chaque critère éliminatoire doit être vérifiable objectivement. Aucun ne doit dépendre du jugement d’un évaluateur sur le ton. Notez le ton ; n’éliminez jamais sur le ton.
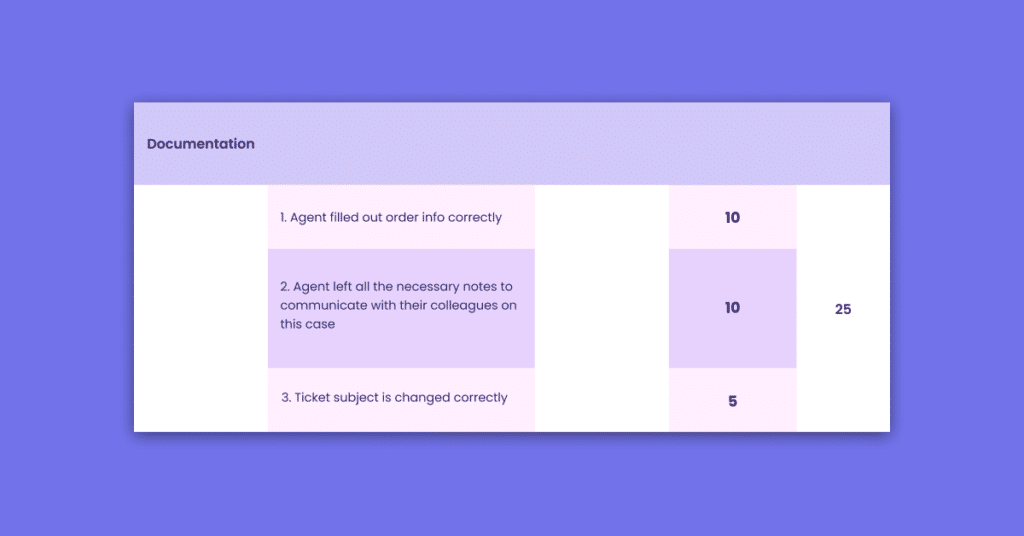
- Suivez les échecs éliminatoires à part de la note. Un conseiller avec un échec éliminatoire et dix-neuf conversations solides est un autre problème qu’un conseiller à 60 % de moyenne. Les fondre dans une même moyenne glissante masque les deux, et un seul zéro dans un mois à cinq conversations fait à lui seul baisser la moyenne de 20 points.
Qu’est-ce qu’une bonne note QA ?
Il n’existe pas de seuil de réussite universel, car il dépend de l’exigence de votre grille. La plupart des programmes matures fixent une zone cible, souvent autour de 85 à 90 % et plus, et considèrent les notes en dessous comme un déclencheur de coaching. Deux choses comptent plus que le chiffre global : les critères éliminatoires qui l’emportent sur lui, et la tendance par conseiller et par équipe dans le temps, surtout sa corrélation avec le CSAT. Une note isolée dit peu de chose ; une tendance à la hausse qui accompagne des clients plus satisfaits dit tout.
Il y a une raison plus dure de ne pas se focaliser sur le chiffre global, et elle tient à l’arithmétique plutôt qu’à la philosophie.
Combien de conversations faut-il évaluer ?
Évaluez 5 à 10 conversations par conseiller et par mois si l’objectif est le coaching, et traitez le résultat comme une indication, pas comme un classement. À cinq évaluations, la marge d’erreur sur le taux de réussite d’un conseiller est d’environ 26 points à 95 % de confiance : classer les conseillers ou conditionner la rémunération exige des échantillons bien plus grands, ou l’évaluation de toutes les conversations.
Les recommandations publiées varient de plus d’un facteur dix, et aucune ne se recoupe avec les autres.
Call Centre Helper recommande 5 à 6 appels par conseiller, Garry Gormley, de FAB Solutions, y voyant le juste équilibre entre équité et coût en ressources. HiveDesk recommande 5 à 10 par conseiller et par mois, puis 10 à 15 pour les nouvelles recrues pendant leurs 90 premiers jours. OttoQA plaide pour environ 65 par conseiller et par mois, mais c’est un argument d’éditeur fondé sur des hypothèses de volume agressives, et il ne cite aucune source. C2Perform donne les bons paramètres statistiques, un niveau de confiance de 95 % et une marge d’erreur de 5 % avec Z = 1,96, sans jamais écrire la formule.
Voici donc le calcul. Considérez chaque conversation évaluée comme réussie ou échouée au regard de votre niveau d’exigence. La marge d’erreur sur le vrai taux de réussite d’un conseiller, à 95 % de confiance, en supposant que ce taux soit réellement de 90 % :
| Conversations évaluées par conseiller | Marge d’erreur |
|---|---|
| 5 | plus ou moins 26,3 points |
| 10 | plus ou moins 18,6 points |
| 25 | plus ou moins 11,8 points |
| 50 | plus ou moins 8,3 points |
| 100 | plus ou moins 5,9 points |
Ces chiffres sont calculés, et non tirés d’une source : 1,96 multiplié par la racine carrée de p(1-p)/n. Traiter le total d’une grille comme un taux de réussite binomial est une simplification, et une simplification délibérée.
Un conseiller évalué cinq fois qui obtient 85 % a un vrai niveau de qualité situé quelque part entre 59 % et 100 % environ. Impossible de le distinguer d’un collègue qui a obtenu 95 %. Pour ramener cela à plus ou moins 5 points, il faudrait environ 139 évaluations par conseiller et par mois.
Ce qu’il faut en faire, honnêtement :
- Ne classez pas les conseillers entre eux sur de petits échantillons, et ne conditionnez pas la rémunération à une moyenne sur cinq conversations. La mesure ne le permet pas.
- Utilisez les petits échantillons pour le coaching. Cinq évaluations ne vous diront pas qu’un conseiller est dans le dernier décile, mais elles vous montreront qu’il saute la vérification. Trouver un comportement précis à corriger demande bien moins de données que classer des personnes.
- Agrégez vers le haut. Cinq évaluations par conseiller dans une équipe de 40 personnes, cela fait 200 points de données à l’échelle de l’équipe, largement assez pour repérer un problème de processus ou de procédure.
- Augmentez l’échantillon là où les enjeux sont élevés : nouvelles recrues, conversations réglementées, et toute personne dont la performance est formellement remise en question.
Évaluer automatiquement chaque conversation supprime ce problème, puisqu’il ne reste plus d’échantillon susceptible de ne pas être représentatif. Cela introduit d’autres risques, traités plus bas.
Le calibrage : des notes équitables
Le calibrage est ce qui rend une grille digne de confiance. Lors d’une séance de calibrage, plusieurs évaluateurs, et de plus en plus l’IA, notent les mêmes conversations indépendamment, puis comparent et réconcilient leurs écarts. Cela fait ressortir les critères ambigus, aligne l’interprétation et construit le standard commun qui fait accepter leurs notes aux conseillers. Sans calibrage, une « note » n’est que l’avis d’une personne. Avec lui, la grille devient une mesure juste et homogène, ce qui est tout l’enjeu.
La plupart des guides s’arrêtent là, sans dire à quoi ressemble un calibrage réussi. Mettez-y des chiffres. Chaque mois, trois à cinq évaluateurs notent indépendamment les six mêmes conversations, sans discussion, puis mesurent deux choses.
L’écart des notes. La différence entre le total le plus haut et le plus bas sur une même conversation. Un seuil de travail pratique est de 10 points sur une grille de 100 points. Au-delà, ce sont les définitions des critères qui sont ambiguës, pas un évaluateur qui se trompe.
L’accord par critère. Repérez sur quels critères précis vos évaluateurs divergent. Ce ne sont presque jamais les critères binaires. Ce sont les échelles d’appréciation aux niveaux non définis. Si vous voulez une mesure formelle, le kappa de Cohen corrige l’accord de la part due au hasard, et les seuils standard de Landis et Koch placent 0,41 à 0,60 en accord modéré, 0,61 à 0,80 en accord important et 0,81 à 1,00 en accord quasi parfait (résumé ici). Visez 0,61 ou mieux sur tout critère qui pèse réellement. En dessous de 0,41, le critère mesure l’évaluateur plutôt que le conseiller.
Corrigez la grille, pas l’évaluateur. Quand le calibrage révèle un désaccord, réécrivez la définition du critère. Demander aux évaluateurs de faire plus d’efforts ne résiste pas à la prochaine conversation ambiguë.
Ce que cela donne du côté des conseillers
Les grilles sont conçues par les managers et vécues par les conseillers, et c’est dans l’écart entre ces deux points de vue que les programmes qualité échouent sans bruit. Les conseillers du support parlent publiquement et en détail de leurs programmes, et les mêmes schémas reviennent.
L’échantillonnage ressemble à de la chance, parce qu’à ces tailles d’échantillon, c’en est en partie. Un conseiller explique qu’il réussit bien sur les types de conversations où il est le plus fort, puis : « I followed my call flow to perfection on my new bookings and yet, they didn’t pull those. » (en substance : j’ai suivi mon script à la perfection sur mes nouvelles réservations, et ce ne sont pas celles-là qui ont été tirées) (r/callcentres) Ce n’est pas de la paranoïa. C’est une marge d’erreur d’environ 26 points, vécue de l’intérieur.
Des échantillons inégaux ruinent la comparaison. Dans une discussion sur la QA automatisée : « This means my score might be based on 20 calls and my coworkers is based on 34. » (en substance : ma note repose peut-être sur 20 appels, celle de mon collègue sur 34) (r/callcentres) Si vous classez les conseillers, gardez une taille d’échantillon constante.
Un seul événement incontrôlable peut ruiner une moyenne glissante. « My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100. » (en substance : mon chien a aboyé et j’ai eu zéro sur un appel qui aurait sinon valu 100) (r/callcentres) C’est le problème de la moyenne avec critères éliminatoires, en conditions réelles.
Des critères qui ignorent le motif de contact passent pour du travail inutile. Un conseiller, noté sur la création de lien avec le client : « I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment. » (en substance : je travaille pour un fournisseur d’énergie, je n’ai pas besoin d’embarquer quelqu’un dans un voyage quand il veut juste faire un paiement) Si votre grille applique les mêmes critères à une réinitialisation de mot de passe et à une déclaration de décès, elle sera mal vécue et mesurera la mauvaise chose. Utilisez des grilles propres à chaque canal ou à chaque type de contact, ou utilisez correctement le N/A.
Une erreur d’évaluateur sans voie de correction empoisonne tout le programme. « 3 of the 4 things that they said I didn’t ask, I absolutely did. » (en substance : sur les 4 choses que je n’aurais pas demandées, j’en ai bel et bien demandé 3) (r/callcentres)
La solution apparaît dans la même discussion, décrite par un analyste QA dont le programme fonctionne. Les évaluateurs s’envoient des appels entre eux « to make sure we’re being fair and accurate » (pour s’assurer d’être justes et précis), les conseillers peuvent contester n’importe quelle note, et quand l’équipe QA s’est trompée, ils « own up to it and award the points back » (le reconnaissent et rendent les points). C’est du calibrage plus une procédure de contestation, et c’est la différence entre une grille à laquelle les gens font confiance et une grille qu’ils se contentent de subir.
Prévoyez donc la contestation. Donnez aux conseillers la conversation évaluée, le détail critère par critère, un délai pour contester et une personne nommée qui tranche. Suivez votre taux de notes révisées. S’il est proche de zéro, les conseillers ont sans doute renoncé. S’il dépasse environ 10 %, votre grille est ambiguë.
Erreurs fréquentes dans une grille d’évaluation QA
- Trop de critères. Une grille surchargée dilue le signal qui compte et ralentit la notation.
- Une formulation floue. Des critères subjectifs produisent des notes incohérentes et la contestation des conseillers.
- Aucune pondération. Traiter tous les critères à égalité masque ce qui compte vraiment.
- Aucun critère éliminatoire. Laisser passer un manquement à la conformité parce que le reste a été bien noté.
- La grille figée. Une grille jamais mise à jour s’écarte de la réalité de l’activité.
Notation manuelle ou automatisée de la grille
Une grille ne vaut que par votre capacité à l’appliquer. Notée à la main, même une excellente grille ne couvre qu’un échantillon, souvent 5 à 10 conversations par conseiller et par mois. Notée par l’IA, comme avec les grilles d’évaluation de Kaizo, la même grille s’applique à chaque conversation, celles des conseillers comme celles des agents IA, de façon homogène, ce qui libère les évaluateurs pour le calibrage et le coaching.
| Notation manuelle | Notation automatisée | |
|---|---|---|
| Couverture | Un échantillon par conseiller | 100 % des conversations |
| Homogénéité | Varie selon l’évaluateur et le jour | Un standard unique et homogène |
| Effort | Des heures de notation chaque semaine | Réaffecté au coaching |
Découvrez comment le contrôle qualité automatisé applique votre grille à chaque conversation, et comment le coaching IA transforme les résultats en développement des conseillers.
Deux équipes montrent ce que cela donne. Chez UiPath, Kaizo a automatisé 100 % de la QA, avec un ROI de 200 % et une hausse de 8 % de la note qualité. SteelSeries a divisé par deux son temps de contrôle qualité, grâce à des résumés par IA de tickets longs et techniques.
Une seule grille pour noter les deux. Kaizo évalue chaque conversation de support, conseiller ou agent IA, selon votre propre grille, et relie chaque note aux preuves qui la justifient. Réserver une démo.
Quand cette grille n’est pas pour vous
Une grille pondérée complète, avec une preuve sur chaque ligne, dépasse les besoins de certaines équipes. Si vous traitez quelques dizaines de conversations par semaine, lisez-les vous-même avec une courte checklist ; la grille devient rentable quand vous ne pouvez plus tout lire. Si vous n’avez pas encore d’agent IA, retirez les lignes 7 à 9 et le critère éliminatoire propre à l’agent IA : le modèle fonctionne alors comme une grille classique pour conseillers. Si vos règles et vos articles d’aide ne sont pas écrits, commencez par là : « réponse exacte » et « règles respectées » ne se notent pas face à un standard qui n’existe que dans la tête des gens. Et s’il vous faut une batterie de tests pour un agent IA avant son lancement, comme des tests de régression de prompts, c’est une autre étape et un autre type d’outil que la notation de conversations terminées.
Versionner votre grille
Votre grille va évoluer, et quand elle évolue, vous cassez votre propre courbe de tendance. Les notes d’avant et d’après ne sont pas comparables, et presque personne ne vous prévient.
Trois pratiques suffisent. Versionnez la grille et associez à chaque évaluation la version utilisée. Ne changez jamais les pondérations en cours de trimestre. Quand vous la modifiez, réévaluez 20 conversations archivées avec l’ancienne et la nouvelle grille pour connaître l’ampleur du décalage, puis annotez le changement sur chaque graphique qui le traverse.
Revoyez la grille deux fois par an au regard de vos motifs d’escalade actuels. Les critères pertinents il y a deux générations de produits survivent souvent bien plus longtemps qu’ils ne le devraient.
En résumé
La grille d’évaluation QA est l’outil le plus important d’un programme qualité. Gardez-la ciblée, pondérez-la selon l’impact, définissez les critères éliminatoires, calibrez-la et mettez-la à jour quand votre activité évolue. Appliquez-la ensuite à 100 % des conversations grâce à l’automatisation, conseillers et agents IA, pour que le standard que vous avez eu tant de mal à définir atteigne vraiment chaque échange, et pas seulement un échantillon. C’est ainsi qu’une grille cesse d’être une checklist et devient le moteur d’une qualité homogène.
Questions fréquentes
Comment calculer une note QA ?
Additionnez les points obtenus, puis divisez par les points réellement disponibles sur cette conversation, et non par le total affiché de la grille. Si un critère de 20 points ne s’appliquait pas, le dénominateur est 80, pas 100. Un conseiller à 68 points obtient 85 % avec la bonne méthode et 68 % avec la mauvaise.
Comment améliorer une note QA faible ?
Regardez les données critère par critère, pas le total. Un 72 % dû à une vérification systématiquement oubliée se corrige en dix minutes. Le même 72 % réparti uniformément sur tous les critères est un tout autre problème. Si vous ne voyez pas quels critères tirent la note vers le bas, c’est votre reporting qu’il faut corriger d’abord.
Comment créer une checklist QA ?
Partez de vos 50 dernières escalades et remboursements, associez à chacun le comportement qui l’aurait évité, et laissez la fréquence fixer vos critères. Limitez la liste à 20 éléments et rédigez une définition d’une phrase pour chaque niveau de note.
Combien de critères doit compter une grille d’évaluation QA ?
Moins que vous ne le pensez. Gardez les critères qui prédisent les résultats client et limitez les critères éliminatoires à cinq. Une grille surchargée dilue le signal, ralentit la notation et demande plus de calibrage pour chaque critère d’appréciation ajouté.
Peut-on utiliser la même grille d’évaluation pour les agents IA et les conseillers ?
Oui, pour les critères qui décrivent le résultat pour le client : une réponse exacte et complète, des règles respectées, une prochaine étape claire et un transfert propre. Ajoutez quelques lignes propres à un seul intervenant, comme l’appui sur vos contenus pour l’agent IA et les notes du dossier pour les conseillers, et marquez N/A les lignes de l’autre intervenant. Comparez ensuite les deux sur les lignes communes uniquement.
Qui corrige une ligne non conforme sur une conversation d’agent IA ?
La personne responsable de ce que l’agent IA a utilisé : le prompt, l’article d’aide, le texte de la règle ou le paramètre. C’est pourquoi chaque ligne non conforme doit indiquer la source à laquelle elle a été comparée. Le conseiller qui a repris la conversation n’est noté que sur sa propre intervention.
Une grille d’évaluation QA peut-elle être notée automatiquement ?
Oui. Le contrôle qualité automatisé applique votre grille à chaque conversation, conseiller ou agent IA, de façon homogène, pendant que les équipes se chargent du calibrage, des contestations et du coaching. Chez Kaizo, AutoPilot évalue chaque conversation dès qu’elle est résolue et relie chaque note aux preuves dans la conversation.
Faut-il des grilles différentes pour le chat, l’e-mail et le téléphone ?
En général oui, au moins des pondérations différentes. Les catégories de base restent les mêmes, mais des critères comme le rythme des réponses ou la maîtrise de l’appel sont propres à chaque canal.
Sources
- Zendesk, formule de l’indice de qualité interne
- Balto, pondérations par section
- VereQuest, grille de comportements sur 100 points et traitement du N/A
- Five9, pondération par résultats et rythme de calibrage
- MaestroQA, catégories de critères éliminatoires
- Call Centre Helper, taille d’échantillon
- HiveDesk, taille d’échantillon selon l’ancienneté
- OttoQA, évaluations par conseiller (affirmation d’éditeur, sans source)
- C2Perform, paramètres de confiance
- Landis et Koch, seuils d’interprétation du kappa
Les marges d’erreur de cette page sont calculées, et non tirées d’une source, et signalées comme telles là où elles apparaissent. Les citations de praticiens proviennent de discussions publiques sur r/callcentres, liées dans le texte.
À lire aussi
- 5 modèles gratuits de grilles d’évaluation QA (en anglais)
- Les critères éliminatoires en QA (en anglais)
- Rédiger des critères qu’une IA peut vraiment noter (en anglais)
- Calibrage QA : animer des séances qui éliminent les biais de notation (en anglais)
Appliquez votre grille d’évaluation QA à 100 % des conversations
Réservez un rendez-vous de 30 minutes et découvrez comment Kaizo évalue chaque conversation, conseiller ou agent IA, selon votre grille et transforme les résultats en coaching.






