Een QA-scorecard, of beoordelingsformulier voor een telefoongesprek, chat of e-mail, maakt van kwaliteit gewogen criteria die je kunt scoren. Je leest wat erin hoort, ziet voorbeelden per kanaal en leert hoe je er een opbouwt en weegt. Plus een gratis template om mee te starten.
De QA-scorecard is de ruggengraat van elk kwaliteitsprogramma. Zit hij goed in elkaar, dan wordt elk gesprek eerlijk beoordeeld op wat er echt toe doet; zit hij slecht in elkaar, dan wordt QA een kwestie van vinkjes zetten. Deze gids laat zien wat een QA-scorecard is, geeft echte voorbeelden per kanaal, legt uit hoe je er een opbouwt, hoe je weegt en scoort, en biedt een gratis template om mee te beginnen.
Wat is een QA-scorecard?
Een QA-scorecard is een gestructureerde lijst van gewogen criteria waarmee je de kwaliteit van een klantenservicegesprek beoordeelt. Elk criterium beschrijft een deel van wat een goede interactie is, en elk gesprek wordt daarop gescoord. Dat levert een totale kwaliteitsscore op die coaching en rapportage aanstuurt.
Zie de scorecard als de definitie van kwaliteit, concreet gemaakt. In plaats van een vaag gevoel dat een gesprek “goed” was, deelt de scorecard kwaliteit op in specifieke, meetbare onderdelen (is het probleem opgelost, klopte de toon, is het beleid gevolgd) en geeft elk onderdeel een gewicht. Dat maakt QA consistent, bruikbaar voor coaching en verdedigbaar.
Waarom de QA-scorecard zo belangrijk is
Met de scorecard staan of vallen de meeste QA-programma’s. Een goede scorecard:
- Zorgt voor consistentie, zodat elke reviewer, en elke AI-beoordeling, volgens dezelfde standaard scoort.
- Maakt feedback concreet, zodat medewerkers precies weten wat ze moeten verbeteren, en niet alleen hun totaalscore kennen.
- Koppelt kwaliteit aan resultaten, door het gedrag te scoren dat CSAT en oplossing echt bepaalt.
- Houdt stand bij kritische vragen, als een medewerker een score aanvecht of een toezichthouder om bewijs vraagt.
Een overvolle of vage scorecard doet het omgekeerde: QA wordt subjectief vinkjes zetten, waar medewerkers niet op vertrouwen en waar managers niets mee kunnen.
Wat een goede QA-scorecard bevat
Elke effectieve scorecard heeft een paar vaste ingrediënten:
- Duidelijke criteria, geschreven als objectieve vragen die je kunt beantwoorden.
- Wegingen die laten zien hoe zwaar elk criterium voor je organisatie telt.
- Een scoreschaal, vaak ja/nee, of een schaal van 1 tot 5 voor criteria met nuance.
- Knock-outregels voor gedrag dat kritisch is voor compliance.
- Secties of categorieën die verwante criteria groeperen, zodat de rapportage leesbaar blijft.
Categorieën en criteria van een QA-scorecard
De meeste QA-scorecards voor klantenservice delen de criteria in vier categorieën in:
| Categorie | Voorbeeldcriteria |
|---|---|
| Oplossing | Is het probleem volledig opgelost? Was de informatie juist? Is de juiste oplossing aangeboden? |
| Compliance | Is de klant geverifieerd? Zijn de verplichte mededelingen gedaan? Is het beleid gevolgd? |
| Communicatie | Was de toon empathisch en professioneel? Was het antwoord duidelijk? Is de zorg van de klant erkend? |
| Efficiëntie | Is het probleem afgehandeld zonder onnodige doorverbindingen, herhalingen of vertraging? |
Voorbeelden per kanaal, inclusief beoordelingsformulier telefoongesprek
Een scorecard moet meebewegen met het kanaal. Hieronder vereenvoudigde voorbeelden.
QA-scorecard voor chat en messaging
| Criterium | Gewicht |
|---|---|
| Probleem correct opgelost | 30% |
| Reactietijd en tempo passend | 15% |
| Duidelijke, goed opgemaakte, empathische berichten | 25% |
| Juiste procedure en verificatie gevolgd | 20% |
| Goede afsluiting en vervolgstappen | 10% |
QA-scorecard voor e-mail en tickets
| Criterium | Gewicht |
|---|---|
| Volledige, juiste oplossing in zo min mogelijk antwoorden | 35% |
| Professionele toon die past bij het merk, en correcte spelling | 25% |
| Compliance en beleid gevolgd | 25% |
| Duidelijke opbouw en vervolgstappen | 15% |
Beoordelingsformulier voor een telefoongesprek
| Criterium | Gewicht |
|---|---|
| Probleem opgelost, juiste informatie | 30% |
| Identiteitsverificatie en compliance | 25% |
| Empathie, actief luisteren, toon | 25% |
| Gespreksregie en efficiëntie | 20% |
Zo bouw je een QA-scorecard op
- Begin bij je definitie van kwaliteit. Schrijf op hoe een uitstekend gesprek er voor je team uitziet en groepeer dat in categorieën.
- Schrijf objectieve criteria. Formuleer elk criterium als een duidelijke vraag die een reviewer of AI consistent kan beantwoorden. Vermijd vage termen als “goede service”.
- Ken wegingen toe. Geef meer gewicht aan wat de klantuitkomst bepaalt. Oplossing en compliance wegen meestal het zwaarst.
- Leg knock-outregels vast. Bepaal welke missers het hele gesprek laten zakken, ongeacht de rest.
- Test en kalibreer. Scoor een batch met je team, vergelijk de resultaten en scherp de formulering aan tot het scoren consistent is.
- Evalueer regelmatig. Werk de scorecard bij als producten, beleid en klantbehoeften veranderen.
Voor een uitgebreidere stap-voor-stapuitleg, zie onze gids over de QA-scorecard.
Gratis QA-scorecardtemplate
Begin met een kant-en-klare, gewogen QA-scorecard die je kunt aanpassen aan je team, voor chat, e-mail en telefonie. Download onze QA-scorecardtemplates en pas de criteria en wegingen aan je eigen definitie van kwaliteit aan.
Een QA-scorecard wegen en scoren
Weging maakt van een checklist (Engelstalig) een score die iets betekent. Een paar principes:
- Weeg op impact. Criteria die oplossing en compliance raken, moeten zwaarder wegen dan cosmetische criteria.
- Houd de schaal eenvoudig. Ja/nee is makkelijk consistent toe te passen; gebruik een schaal van 1 tot 5 alleen waar nuance echt telt.
- Normaliseer naar 100. Een totaalpercentage is makkelijk te volgen in de tijd en te vergelijken tussen teams.
- Weeg subjectiviteit niet te zwaar. Hoe meer een criterium afhangt van de mening van de reviewer, hoe meer kalibratie het nodig heeft.
Gepubliceerde scorecards zijn het oneens, en dat is precies het punt
Er bestaat geen standaardweging in de branche, en de leveranciers die de hunne publiceren, zijn het niet met elkaar eens. Balto weegt per sectie: begroeting 10%, communicatie 25%, compliance 20%, oplossing 25%, afsluiting 20%. VereQuest publiceert een gedragsscorecard van 100 punten die probleemoplossing 20 punten geeft, empathie 15 en eigenaarschap 15, met de begroeting op 5 en het gebruik van de naam van de klant op 2. Five9 weegt uitkomsten in plaats van gedrag: CSAT 30%, FCR 25%, QA-score 20%, AHT 15%, roosteradherentie 10%.
Balto geeft dertig van de honderd punten aan hoe het gesprek begint en eindigt. Onze kanaalscorecards hierboven geven daar bijna niets voor. Geen van beide is fout. Wegingen zijn een zakelijke keuze, geen best practice die je kunt kopiëren, dus leid je eigen wegingen af:
- Begin bij wat er echt misgaat. Pak je laatste 50 escalaties, terugbetalingen en klachten en label elk geval met het gedrag dat het had kunnen voorkomen. Als 30 daarvan terug te voeren zijn op verkeerde informatie die met overtuiging is gegeven, verdient juistheid meer dan 5 punten.
- Controleer of de wegingen iets voorspellen. Scoor 100 gesprekken en correleer de sectiescores met de CSAT of de oplossing van diezelfde gesprekken. Als je toonscore geen verband heeft met of de klant uiteindelijk tevreden was, hoort die geen 20 punten te dragen. Het is een halve dag werk in een spreadsheet en bijna niemand doet het.
De N.v.t.-valkuil die de meeste scorecards ongemerkt breekt
Is een criterium niet van toepassing op een gesprek, haal de punten dan uit de noemer. Scoor het niet als nul, en laat het ook niet stilletjes staan.
De rekensom doet er meer toe dan je zou denken. Een medewerker haalt 68 punten op een scorecard waarop een criterium van 20 punten echt niet van toepassing was. Delen door het verlaagde totaal geeft 68 van de 80, oftewel 85%. Delen door de oorspronkelijke 100 geeft 68%. Dat is een verschil van 17 punten, volledig veroorzaakt door een boekhoudkundige keuze.
VereQuest behandelt dit expliciet en merkt op dat bij gebruik van N.v.t. “the total % or total # of points is reduced by that amount” (het totale percentage of het totale aantal punten wordt met die hoeveelheid verlaagd). Controleer wat je tool standaard doet, want niet elke tool doet het goed. Wil je de algemene vorm, dan is de interne kwaliteitsscore van Zendesk de som van de beoordelingen gedeeld door de maximaal beschikbare score over alle categorieën. Het belangrijke woord is beschikbaar, niet mogelijk.
Knock-outcriteria
Sommige missers zijn zo ernstig dat het gesprek moet zakken, ook bij een verder sterke score. Typische knock-outs zijn een overgeslagen identiteitsverificatie, een weggelaten wettelijke mededeling, het delen van onjuiste gereguleerde informatie of een ernstige schending van het vertrouwen van de klant. Door knock-outs expliciet vast te leggen, blijft je scorecard eerlijk: een gesprek dat elk communicatievakje afvinkt maar de compliance schendt, is geen goed gesprek, en de score moet dat laten zien.
MaestroQA onderscheidt drie legitieme categorieën: schendingen van compliance en beveiliging, zoals het blootgeven van kaartgegevens of het overslaan van verificatie, bewust verkeerde informatie geven, en grensoverschrijdend gedrag. Drie regels houden knock-outs werkbaar:
- Beperk de lijst tot vijf. Als alles kritisch is, is niets kritisch.
- Elke knock-out moet objectief controleerbaar zijn. Geen enkele mag afhangen van het oordeel van een reviewer over de toon. Scoor de toon; maak er nooit een knock-out van.
- Rapporteer knock-outs los van de score. Een medewerker met één knock-out en negentien sterke gesprekken is een ander probleem dan een medewerker met een gemiddelde van 60%. Als je ze in één voortschrijdend gemiddelde samenvoegt, verberg je beide, en één nul in een maand met vijf gesprekken drukt het gemiddelde in zijn eentje al 20 punten omlaag.
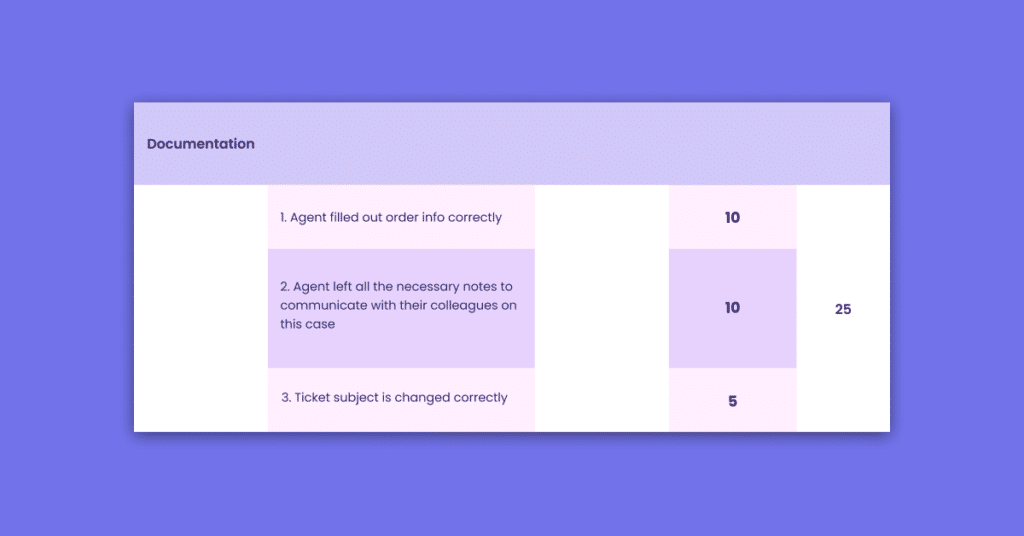
Wat is een goede QA-score?
Er bestaat geen universele norm, want die hangt af van hoe streng je scorecard is. De meeste volwassen programma’s hanteren een doelbandbreedte, vaak rond 85 tot 90% en hoger, en zien scores daaronder als aanleiding voor coaching. Twee dingen tellen zwaarder dan het totaalcijfer: de knock-outcriteria die het overrulen, en de trend per medewerker en per team in de tijd, vooral of die samenhangt met CSAT. Eén losse score zegt weinig; een stijgende trend die samengaat met tevredener klanten zegt alles.
Er is een hardere reden om je niet blind te staren op het totaalcijfer, en die is rekenkundig, niet filosofisch.
Hoeveel gesprekken moet je beoordelen?
Gepubliceerde adviezen lopen meer dan een factor tien uiteen, en geen enkel advies sluit aan op de rest.
Call Centre Helper raadt 5 tot 6 gesprekken per medewerker aan, waarbij Garry Gormley van FAB Solutions dat het optimale punt noemt tussen eerlijkheid en de kosten aan capaciteit. HiveDesk raadt 5 tot 10 per medewerker per maand aan, oplopend tot 10 tot 15 voor nieuwe medewerkers in hun eerste 90 dagen. OttoQA pleit voor zo’n 65 per medewerker per maand, al is dat een leveranciersargument op basis van agressieve volumeaannames, en het noemt geen enkele bron. C2Perform noemt de juiste statistische parameters, 95% betrouwbaarheid en een foutmarge van 5% met Z = 1,96, maar geeft de formule nergens.
Hier is dus de rekensom. Behandel elk beoordeeld gesprek als geslaagd of gezakt ten opzichte van je kwaliteitsnorm. De foutmarge op het echte slagingspercentage van een medewerker bij 95% betrouwbaarheid, als dat percentage werkelijk 90% is:
| Beoordeelde gesprekken per medewerker | Foutmarge |
|---|---|
| 5 | plus of min 26,3 punten |
| 10 | plus of min 18,6 punten |
| 25 | plus of min 11,8 punten |
| 50 | plus of min 8,3 punten |
| 100 | plus of min 5,9 punten |
Deze cijfers zijn berekend, niet uit een bron overgenomen: 1,96 maal de wortel van p(1-p)/n. Een scorecardtotaal behandelen als een binomiaal slagingspercentage is een vereenvoudiging, en een bewuste.
Een medewerker die vijf keer is beoordeeld en 85% scoort, heeft een echt kwaliteitsniveau ergens tussen ongeveer 59% en 100%. Je kunt die medewerker niet onderscheiden van een collega die 95% scoorde. Om dat terug te brengen tot plus of min 5 punten heb je ongeveer 139 beoordelingen per medewerker per maand nodig.
Wat je daar eerlijk gezegd mee doet:
- Doe het niet: rangschik medewerkers niet tegen elkaar op kleine steekproeven, en koppel beloning niet aan een gemiddelde van vijf gesprekken. De meting kan dat niet dragen.
- Doe het wel: gebruik kleine steekproeven voor coaching. Vijf beoordelingen vertellen je niet dat een medewerker in het laagste deciel zit, maar laten wel zien dat deze medewerker de verificatie overslaat. Een specifiek gedrag vinden dat je kunt verbeteren, vraagt veel minder data dan mensen rangschikken.
- Doe het wel: aggregeer naar een hoger niveau. Vijf beoordelingen per medewerker in een team van 40 mensen zijn 200 datapunten op teamniveau, ruim genoeg om een proces- of beleidsprobleem te zien.
- Doe het wel: vergroot de steekproef waar veel op het spel staat: nieuwe medewerkers, gereguleerde gesprekken en iedereen van wie de prestaties formeel ter discussie staan.
Elk gesprek automatisch scoren haalt dit probleem weg, omdat er geen steekproef meer overblijft die niet representatief kan zijn. Het brengt wel andere risico’s mee, die verderop aan bod komen.
Kalibratie: eerlijke scores
Kalibratie maakt een scorecard betrouwbaar. In een kalibratiesessie scoren meerdere reviewers, en steeds vaker ook de AI, dezelfde gesprekken onafhankelijk van elkaar, en vergelijken en verzoenen ze daarna de verschillen. Zo komen dubbelzinnige criteria boven water, wordt de interpretatie gelijkgetrokken en ontstaat de gedeelde standaard waardoor medewerkers hun scores accepteren. Zonder kalibratie is een “score” gewoon de mening van één persoon. Met kalibratie wordt de scorecard een eerlijke, consistente maatstaf, en daar draait het om.
De meeste adviezen stoppen hier, zonder te zeggen hoe een geslaagde kalibratie eruitziet. Hang er cijfers aan. Laat elke maand drie tot vijf reviewers onafhankelijk dezelfde zes gesprekken scoren, zonder overleg, en meet daarna twee dingen.
Spreiding van de scores. Het verschil tussen het hoogste en het laagste totaal op hetzelfde gesprek. Een praktische werkdrempel is 10 punten op een scorecard van 100 punten. Alles daarboven betekent dat de definities van de criteria dubbelzinnig zijn, niet dat een reviewer het fout heeft.
Overeenstemming per criterium. Zoek uit over welke specifieke criteria je reviewers het oneens zijn. Dat zijn bijna nooit de binaire. Het zijn de oordeelsschalen met ongedefinieerde punten. Wil je een formele maat, dan corrigeert Cohens kappa de overeenstemming voor toeval, en de standaardbanden van Landis en Koch plaatsen 0,41 tot 0,60 bij matig, 0,61 tot 0,80 bij substantieel en 0,81 tot 1,00 bij bijna perfect (hier samengevat). Mik op 0,61 of hoger voor elk criterium met echt gewicht. Onder 0,41 meet het criterium de reviewer in plaats van de medewerker.
Verbeter de scorecard, niet de reviewer. Als kalibratie onenigheid aan het licht brengt, herschrijf dan de definitie van het criterium. Reviewers vragen om beter hun best te doen helpt niet: dat houdt geen stand bij het volgende dubbelzinnige gesprek.
Hoe het eruitziet vanuit de medewerker gezien
Scorecards worden ontworpen door managers en ervaren door medewerkers, en in de kloof tussen die twee perspectieven gaan kwaliteitsprogramma’s ongemerkt onderuit. Supportmedewerkers bespreken hun programma’s openlijk en in detail, en steeds keren dezelfde patronen terug.
Steekproeven voelen als geluk, omdat het bij deze steekproefgroottes deels ook zo is. Een medewerker beschrijft hoe goed hij presteert op de gesprekstypen waar hij het sterkst in is, en dan: “I followed my call flow to perfection on my new bookings and yet, they didn’t pull those.” (kort gezegd: ik volgde mijn gespreksflow perfect bij mijn nieuwe boekingen, en toch kozen ze die niet) (r/callcentres) Dat is geen paranoia. Het is een foutmarge van ongeveer 26 punten, van binnenuit beleefd.
Ongelijke steekproeven maken de vergelijking kapot. Uit een discussie over geautomatiseerde QA: “This means my score might be based on 20 calls and my coworkers is based on 34.” (kort gezegd: mijn score is misschien gebaseerd op 20 gesprekken en die van mijn collega op 34) (r/callcentres) Als je medewerkers al rangschikt, houd de steekproefgrootte dan gelijk.
Eén onbeheersbare gebeurtenis kan een voortschrijdend gemiddelde verwoesten. “My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100.” (kort gezegd: mijn hond blafte en ik kreeg een nul op een gesprek dat anders een perfecte 100 was geweest) (r/callcentres) Dat is het probleem van knock-outs in een gemiddelde, in de praktijk.
Criteria die de contactreden negeren, voelen als bezigheidstherapie. Een medewerker, beoordeeld op het opbouwen van een band met de klant: “I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment.” (kort gezegd: ik werk voor een energieleverancier, ik hoef niemand mee op reis te nemen als die alleen een betaling wil doen) Als je scorecard dezelfde criteria toepast op een wachtwoordreset en op een overlijdensmelding, roept dat weerstand op en meet het het verkeerde. Gebruik scorecards per kanaal of per contacttype, of gebruik N.v.t. op de juiste manier.
Fouten van reviewers zonder correctiemogelijkheid vergiftigen het hele programma. “3 of the 4 things that they said I didn’t ask, I absolutely did.” (kort gezegd: van de 4 dingen die ik volgens hen niet vroeg, heb ik er 3 wel degelijk gevraagd) (r/callcentres)
De oplossing staat in diezelfde discussie, beschreven door een QA-analist van wie het programma wel werkt. Ze sturen elkaar gesprekken door “to make sure we’re being fair and accurate” (om zeker te weten dat ze eerlijk en nauwkeurig zijn), medewerkers kunnen elke score aanvechten, en als het QA-team het fout heeft, “own up to it and award the points back” (geven ze dat toe en krijgt de medewerker de punten terug). Dat is kalibratie plus een bezwaarprocedure, en dat is het verschil tussen een scorecard die mensen vertrouwen en een die ze alleen maar ondergaan.
Bouw de bezwaarprocedure er dus in. Geef medewerkers het gescoorde gesprek, de uitsplitsing per criterium, een termijn om bezwaar te maken en een vaste persoon die beslist. Houd bij hoe vaak een score wordt herzien. Ligt dat percentage bijna op nul, dan doen medewerkers waarschijnlijk geen moeite meer. Ligt het boven ongeveer 10%, dan is je scorecard dubbelzinnig.
QA-scorecard versus beoordelingscriteria
De termen worden vaak door elkaar gebruikt. Beoordelingscriteria (in het Engels rubric) verwijzen meestal naar de gedetailleerde scorerichtlijnen, wat elke score op elk criterium oplevert, terwijl de QA-scorecard het totale gestructureerde instrument is: de criteria, wegingen en scoring samen. In de praktijk bevat een goede scorecard die gedetailleerde richtlijnen, zodat reviewers en AI elk criterium op dezelfde manier interpreteren.
Veelgemaakte fouten met QA-scorecards
- Te veel criteria. Een overvolle scorecard verdunt het signaal dat ertoe doet en vertraagt het scoren.
- Vage formuleringen. Subjectieve criteria leveren inconsistente scores en weerstand van medewerkers op.
- Geen weging. Elk criterium even zwaar laten tellen verbergt wat er echt toe doet.
- Geen knock-outs. Een complianceschending door laten glippen omdat de rest goed scoorde.
- Instellen en vergeten. Een scorecard die nooit wordt bijgewerkt, raakt los van de organisatie.
Voor een checklist van wat je niet moet doen, zie de checklist met valkuilen voor QA-scorecards.
Handmatig versus geautomatiseerd scoren
Een scorecard is maar zo nuttig als je vermogen om hem toe te passen. Handmatig gescoord bereikt zelfs een uitstekende scorecard minder dan 5% van de gesprekken. Gescoord door AI, zoals met de scorecards van Kaizo, wordt dezelfde scorecard op 100% toegepast, consistent, zodat reviewers tijd overhouden voor kalibratie en coaching.
| Handmatig scoren | Geautomatiseerd scoren | |
|---|---|---|
| Dekking | Minder dan 5% van de gesprekken | 100% van de gesprekken |
| Consistentie | Wisselt per reviewer en per dag | Eén consistente standaard |
| Inspanning | Elke week uren beoordelen | Ingezet voor coaching |
Bekijk hoe geautomatiseerde kwaliteitscontrole je scorecard op elk gesprek toepast, en hoe AI-coaching de resultaten omzet in ontwikkeling van medewerkers.
100% van de gesprekken gescoord op je scorecard, tegenover het handmatige gemiddelde van minder dan 5%
100% van de QA geautomatiseerd bij UiPath, met +8% kwaliteitsscore per kwartaal
75% minder voorbereidingstijd voor coaching bij EverHelp, over 16 domeinen
QA-scorecards voor gesprekken die AI afhandelt
Nu AI-agents gesprekken gaan afhandelen, moet dezelfde scorecard ook hen beoordelen, volgens één standaard, zodat je de kwaliteit van mensen en AI direct kunt vergelijken. Een goed opgebouwde scorecard, toegepast op 100% van de gesprekken, wordt de gedeelde kwaliteitsnorm voor je hele organisatie, voor mensen en AI.
Je scorecard versioneren
Je scorecard gaat veranderen, en als dat gebeurt, breek je je eigen trendlijn. Scores van voor en na zijn niet vergelijkbaar, en bijna niemand waarschuwt je daarvoor.
Drie werkwijzen zijn genoeg. Geef de scorecard een versienummer en zet bij elke beoordeling de gebruikte versie. Verander de wegingen nooit midden in een kwartaal. Verander je hem wel, scoor dan 20 gearchiveerde gesprekken opnieuw met zowel de oude als de nieuwe scorecard, zodat je weet hoe groot de verschuiving is, en markeer de wijziging in elke grafiek die eroverheen loopt.
Evalueer de scorecard twee keer per jaar aan de hand van je huidige escalatieredenen. Criteria die twee productgeneraties geleden logisch waren, overleven meestal veel langer dan zou moeten.
Tot slot
De QA-scorecard is het belangrijkste instrument in een kwaliteitsprogramma. Houd hem gericht, weeg op impact, leg knock-outs vast, kalibreer en werk hem bij als je organisatie verandert. Pas hem daarna met automatisering toe op 100% van de gesprekken, zodat de standaard die je zo zorgvuldig hebt opgesteld echt elke interactie bereikt, niet alleen een steekproef. Zo wordt een scorecard geen checklist meer, maar de motor van consistente kwaliteit.
Veelgestelde vragen
Hoe bereken je een QA-score?
Tel de behaalde punten op en deel die door de punten die op dat gesprek echt beschikbaar waren, niet door het nominale totaal van de scorecard. Was een criterium van 20 punten niet van toepassing, dan is de noemer 80, niet 100. Een medewerker met 68 punten scoort volgens de juiste methode 85% en volgens de verkeerde 68%.
Hoeveel gesprekken moet ik per medewerker beoordelen?
Vijf tot tien per medewerker per maand is het gangbare advies, en dat is genoeg om gedrag te vinden waarop je kunt coachen. Het is niet genoeg om medewerkers tegen elkaar te rangschikken of beloning eraan te koppelen, want bij vijf beoordelingen is de foutmarge zo’n 26 procentpunten. Heb je individuele vergelijkingen nodig, vergroot de steekproef dan flink of scoor alles automatisch.
Hoe verbeter ik een lage QA-score?
Kijk naar de data per criterium, niet naar het totaal. Een 72% die komt doordat de verificatie steeds wordt vergeten, los je in tien minuten op. Dezelfde 72% die gelijk verdeeld is over alle criteria, is een heel ander probleem. Kun je niet zien welke criteria de score omlaag trekken, dan moet je eerst je rapportage verbeteren.
Hoe maak ik een QA-checklist?
Begin bij je laatste 50 escalaties en terugbetalingen, label elk geval met het gedrag dat het had kunnen voorkomen, en laat de frequentie je criteria bepalen. Beperk de lijst tot 20 punten en schrijf voor elk scoreniveau een definitie van één zin.
Wat is het verschil tussen een QA-scorecard en beoordelingscriteria?
De beoordelingscriteria zijn de gedetailleerde scorerichtlijnen per criterium; de scorecard is het totale instrument van criteria, wegingen en scoring. Goede scorecards bevatten die gedetailleerde richtlijnen.
Hoeveel criteria moet een QA-scorecard hebben?
Minder dan je denkt. Richt je op de criteria die klantuitkomsten voorspellen. Een overvolle scorecard verdunt het signaal en vertraagt het scoren.
Kan een QA-scorecard automatisch worden gescoord?
Ja. Geautomatiseerde kwaliteitscontrole past je scorecard met AI consistent toe op 100% van de gesprekken, terwijl mensen zich bezighouden met kalibratie en coaching.
Heb je verschillende scorecards nodig voor chat, e-mail en telefonie?
Meestal wel, in elk geval met andere wegingen. De kerncategorieën blijven gelijk, maar criteria als reactietempo of gespreksregie zijn kanaalspecifiek.
Bronnen
- Zendesk, formule voor de interne kwaliteitsscore
- Balto, wegingen per sectie
- VereQuest, gedragsscorecard van 100 punten en omgang met N.v.t.
- Five9, weging op uitkomsten en kalibratieritme
- MaestroQA, categorieën knock-outcriteria
- Call Centre Helper, steekproefgrootte
- HiveDesk, steekproefgrootte naar ervaring
- OttoQA, beoordelingen per medewerker (leveranciersclaim, zonder bron)
- C2Perform, betrouwbaarheidsparameters
- Landis en Koch, interpretatiebanden voor kappa
De foutmarges op deze pagina zijn berekend, niet uit een bron overgenomen, en zijn op de plek waar ze staan als zodanig aangeduid. De citaten uit de praktijk komen uit openbare discussies op r/callcentres en zijn in de tekst gelinkt.
Verder lezen
- 5 gratis QA-scorecardtemplates (Engelstalig)
- Knock-outcriteria in QA (Engelstalig)
- Beoordelingscriteria schrijven die een AI echt kan scoren (Engelstalig)
- QA-kalibratie: sessies die scoringsbias wegnemen (Engelstalig)
Pas je QA-scorecard toe op 100% van de gesprekken
Boek een demo van 30 minuten en zie hoe Kaizo elk gesprek automatisch scoort op je scorecard en de resultaten omzet in coaching.





