Una scorecard call center, o scorecard de QA, convierte la calidad en criterios ponderados que se pueden evaluar. Vea qué debe incluir, ejemplos por canal, cómo crearla y ponderarla, y una plantilla gratuita para empezar.
La scorecard de QA es la columna vertebral de cualquier programa de calidad. Si está bien hecha, cada conversación se evalúa con justicia frente a lo que de verdad importa; si está mal hecha, el QA se convierte en marcar casillas. Esta guía explica qué es una scorecard de QA, muestra ejemplos reales por canal, cómo crear una, cómo ponderarla y calcular la nota, y ofrece una plantilla gratuita como punto de partida.
¿Qué es una scorecard de QA?
Una scorecard de QA es una lista estructurada de criterios ponderados que sirve para evaluar la calidad de una conversación de atención al cliente. Cada criterio define una parte de lo que es una buena interacción, y cada conversación se evalúa frente a ellos para obtener una nota de calidad global que orienta el coaching y los reportes.
Piense en la scorecard como la definición de calidad hecha concreta. En lugar de la vaga sensación de que una conversación fue «buena», la scorecard divide la calidad en elementos específicos y medibles (si se resolvió el problema, si el tono fue el adecuado, si se siguió la política) y asigna un peso a cada uno. Es lo que hace que el QA sea coherente, útil para el coaching y defendible.
Por qué importa la scorecard de QA
La scorecard es donde la mayoría de los programas de QA triunfan o fracasan. Una buena scorecard:
- Crea coherencia, para que cada revisor, y cada evaluación con IA, califique con el mismo estándar.
- Hace que la retroalimentación sea concreta, para que los agentes sepan exactamente qué mejorar, y no solo su nota global.
- Alinea la calidad con los resultados, al evaluar los comportamientos que de verdad impulsan el CSAT y la resolución.
- Resiste el escrutinio cuando un agente cuestiona una nota o un regulador pide pruebas.
Una scorecard sobrecargada o ambigua consigue lo contrario: convierte el QA en un ejercicio subjetivo de marcar casillas del que los agentes desconfían y del que los managers no pueden sacar nada útil.
Qué incluye una buena scorecard de QA
Toda scorecard eficaz tiene unos pocos ingredientes comunes:
- Criterios claros, redactados como preguntas objetivas que se pueden responder.
- Pesos que reflejan cuánto importa cada criterio para su negocio.
- Una escala de evaluación, a menudo sí/no, o un rango de 1 a 5 para los criterios con matices.
- Reglas de error crítico para los comportamientos críticos de cumplimiento normativo.
- Secciones o categorías que agrupan los criterios relacionados para que los reportes sean legibles.
Categorías y criterios de una scorecard de QA
La mayoría de las scorecards de QA de atención al cliente organizan los criterios en cuatro categorías:
| Categoría | Criterios de ejemplo |
|---|---|
| Resolución | ¿Se resolvió el problema por completo? ¿Fue correcta la información? ¿Se ofreció la solución adecuada? |
| Cumplimiento | ¿Se verificó al cliente? ¿Se dieron los avisos obligatorios? ¿Se siguió la política? |
| Comunicación | ¿Fue el tono empático y profesional? ¿Fue clara la respuesta? ¿Se reconoció la preocupación del cliente? |
| Eficiencia | ¿Se gestionó el problema sin transferencias, repeticiones ni demoras innecesarias? |
Ejemplos de scorecard por canal
Una scorecard debe adaptarse al canal. Estos son ejemplos simplificados.
Scorecard de QA para chat y mensajería
| Criterio | Peso |
|---|---|
| Problema resuelto con exactitud | 30% |
| Tiempo de respuesta y ritmo adecuados | 15% |
| Mensajes claros, bien formateados y empáticos | 25% |
| Proceso y verificación correctos | 20% |
| Cierre adecuado y próximos pasos | 10% |
Scorecard de QA para correo electrónico y tickets
| Criterio | Peso |
|---|---|
| Resolución completa y exacta en el menor número de respuestas | 35% |
| Tono profesional, acorde a la marca, y buena redacción | 25% |
| Cumplimiento y política respetados | 25% |
| Estructura clara y próximos pasos | 15% |
Scorecard de QA para llamadas
| Criterio | Peso |
|---|---|
| Problema resuelto, información correcta | 30% |
| Verificación de identidad y cumplimiento | 25% |
| Empatía, escucha activa, tono | 25% |
| Control de la llamada y eficiencia | 20% |
Cómo crear una scorecard call center
- Parta de su definición de calidad. Enumere cómo es una gran conversación para su equipo y agrupe esos elementos en categorías.
- Redacte criterios objetivos. Formule cada uno como una pregunta clara que un revisor o una IA pueda responder de forma coherente. Evite términos vagos como «buen servicio».
- Asigne pesos. Dé más peso a lo que impulsa los resultados para el cliente. La resolución y el cumplimiento suelen pesar más.
- Defina los errores críticos. Decida qué fallos invalidan toda la conversación, sea cual sea el resto.
- Haga un piloto y calibre. Evalúe un lote con su equipo, compare resultados y ajuste la redacción hasta que la evaluación sea coherente.
- Revísela con regularidad. Actualice la scorecard a medida que cambian los productos, las políticas y las necesidades de los clientes.
Para un recorrido más detallado, consulte nuestra guía de la scorecard de QA.
Plantilla gratuita de scorecard de QA
Parta de una scorecard de QA ya ponderada que puede adaptar a su equipo, para chat, correo electrónico y voz. Descargue nuestras plantillas de scorecard de QA y personalice los criterios y los pesos según su definición de calidad.
Ponderar y calcular la nota de una scorecard de QA
La ponderación es lo que convierte una checklist (en inglés) en una nota con sentido. Algunos principios:
- Pondere según el impacto. Los criterios que afectan a la resolución y al cumplimiento deben pesar más que los cosméticos.
- Mantenga una escala sencilla. El sí/no es fácil de aplicar de forma coherente; use un rango de 1 a 5 solo donde el matiz de verdad importa.
- Normalice a 100. Un porcentaje global es fácil de seguir en el tiempo y de comparar entre equipos.
- Evite sobreponderar lo subjetivo. Cuanto más dependa un criterio de la opinión del revisor, más calibración necesita.
Las scorecards publicadas no coinciden, y esa es la cuestión
No existe una ponderación estándar del sector, y los proveedores que publican la suya no coinciden. Balto pondera por sección: saludo 10%, comunicación 25%, cumplimiento 20%, resolución 25%, cierre 20%. VereQuest publica una scorecard de comportamientos de 100 puntos que da 20 a la resolución de problemas, 15 a la empatía y 15 a la responsabilidad, con 5 para el saludo y 2 para usar el nombre del cliente. Five9 pondera resultados en lugar de comportamientos: CSAT 30%, FCR 25%, nota de QA 20%, TMO 15%, adherencia 10%.
Balto dedica treinta de cien puntos a cómo empieza y termina la conversación. Nuestras scorecards por canal de arriba no le dedican casi nada. Ninguna está equivocada. Los pesos son una decisión de negocio, no una buena práctica que se pueda copiar, así que obtenga los suyos:
- Parta de lo que de verdad sale mal. Reúna sus últimos 50 escalamientos, reembolsos y quejas y etiquete cada uno con el comportamiento que lo habría evitado. Si 30 de ellos se deben a información incorrecta dada con seguridad, la exactitud merece más de 5 puntos.
- Compruebe que los pesos predicen algo. Evalúe 100 conversaciones y correlacione las notas por sección con el CSAT o la resolución de esas mismas conversaciones. Si su nota de tono no tiene relación con que el cliente termine satisfecho, no debería valer 20 puntos. Es medio día en una hoja de cálculo y casi nadie lo hace.
La trampa del N/A que rompe en silencio la mayoría de las scorecards
Si un criterio no aplica a una conversación, retire sus puntos del denominador. No lo evalúe con cero, y no lo deje dentro sin más.
La aritmética importa más de lo que parece. Un agente obtiene 68 puntos en una scorecard en la que un criterio de 20 puntos de verdad no aplicaba. Dividir por el total reducido da 68 de 80, es decir, 85%. Dividir por los 100 originales da 68%. Es una diferencia de 17 puntos producida únicamente por una decisión contable.
VereQuest lo trata de forma explícita y señala que, cuando se usa N/A, «the total % or total # of points is reduced by that amount» (el porcentaje total o el número total de puntos se reduce en esa cantidad). Compruebe qué hace su herramienta por defecto, porque no todas lo hacen bien. Si quiere la fórmula general, la nota de calidad interna de Zendesk es la suma de las evaluaciones dividida por la nota máxima disponible en todas las categorías. La palabra importante es disponible, no posible.
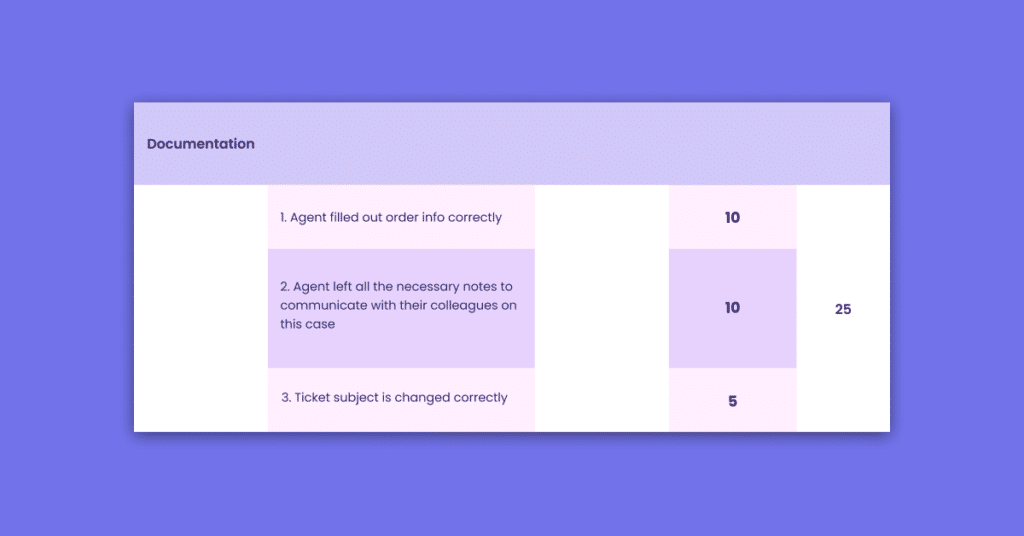
Errores críticos (PEC)
Algunos fallos son tan graves que la conversación debe considerarse fallida aunque el resto de la nota sea sólida. Los errores críticos típicos incluyen saltarse la verificación de identidad, omitir un aviso legal, compartir información regulada incorrecta o una falta grave a la confianza del cliente. Definir los errores críticos de forma explícita mantiene honesta su scorecard: una conversación que marca todas las casillas de comunicación pero incumple la normativa no es una buena conversación, y la nota debe decirlo.
MaestroQA identifica tres categorías legítimas: infracciones de cumplimiento y seguridad, como exponer datos de tarjetas o saltarse la verificación, dar a sabiendas información incorrecta y la conducta abusiva. Tres reglas hacen que los errores críticos sean sostenibles:
- Limite la lista a cinco. Si todo es crítico, nada lo es.
- Cada error crítico debe ser verificable de forma objetiva. Ninguno debe depender del juicio de un revisor sobre el tono. Evalúe el tono; nunca lo convierta en error crítico.
- Reporte los errores críticos por separado de la nota. Un agente con un error crítico y diecinueve conversaciones sólidas es un problema distinto de un agente con una media del 60%. Mezclarlos en una misma media móvil oculta ambos, y un solo cero en un mes de cinco conversaciones baja la media 20 puntos por sí solo.
¿Qué es una buena nota de QA?
No existe una nota de aprobado universal, porque depende de lo exigente que sea su scorecard. La mayoría de los programas maduros fijan una franja objetivo, a menudo entre el 85 y el 90% o más, y tratan las notas inferiores como una señal para hacer coaching. Dos cosas importan más que la cifra global: los errores críticos que la anulan y la tendencia por agente y por equipo a lo largo del tiempo, sobre todo si se correlaciona con el CSAT. Una nota aislada dice poco; una tendencia al alza que acompaña a clientes más satisfechos lo dice todo.
Hay una razón más dura para no obsesionarse con la cifra global, y es aritmética, no filosofía.
¿Cuántas conversaciones debe revisar?
Las recomendaciones publicadas varían en más de diez veces, y ninguna encaja con las demás.
Call Centre Helper recomienda de 5 a 6 llamadas por agente, y Garry Gormley, de FAB Solutions, lo considera el punto óptimo entre equidad y coste de recursos. HiveDesk recomienda de 5 a 10 por agente al mes, cifra que sube a entre 10 y 15 para las nuevas incorporaciones en sus primeros 90 días. OttoQA defiende unas 65 por agente al mes, aunque es un argumento de proveedor basado en supuestos de volumen agresivos y no cita ninguna fuente. C2Perform nombra los parámetros estadísticos correctos, un 95% de confianza y un 5% de margen de error con Z = 1,96, y nunca escribe la fórmula.
Así que aquí está la aritmética. Trate cada conversación revisada como aprobada o suspendida frente a su nivel de calidad. El margen de error sobre la tasa real de aprobación de un agente con un 95% de confianza, suponiendo que esa tasa sea realmente del 90%:
| Conversaciones revisadas por agente | Margen de error |
|---|---|
| 5 | más o menos 26,3 puntos |
| 10 | más o menos 18,6 puntos |
| 25 | más o menos 11,8 puntos |
| 50 | más o menos 8,3 puntos |
| 100 | más o menos 5,9 puntos |
Estas cifras están calculadas, no tomadas de una fuente: 1,96 multiplicado por la raíz cuadrada de p(1-p)/n. Tratar el total de una scorecard como una tasa de aprobación binomial es una simplificación, y deliberada.
Un agente revisado cinco veces que obtiene un 85% tiene una tasa de calidad real de entre aproximadamente el 59% y el 100%. No se le puede distinguir de un compañero que obtuvo un 95%. Para reducir eso a más o menos 5 puntos harían falta unas 139 revisiones por agente al mes.
Qué hacer con esto, con honestidad:
- No clasifique a los agentes entre sí con muestras pequeñas, ni vincule la remuneración a una media de cinco conversaciones. La medición no lo sostiene.
- Sí use las muestras pequeñas para el coaching. Cinco revisiones no le dirán que un agente está en el decil inferior, pero sí le mostrarán que se salta la verificación. Encontrar un comportamiento concreto y corregible necesita muchos menos datos que clasificar a personas.
- Sí agregue hacia arriba. Cinco revisiones por agente en un equipo de 40 personas son 200 datos a nivel de equipo, más que suficiente para detectar un problema de proceso o de política.
- Sí aumente la muestra donde hay mucho en juego: nuevas incorporaciones, conversaciones reguladas y cualquier persona cuyo desempeño esté formalmente en cuestión.
Evaluar todas las conversaciones de forma automática elimina este problema, porque ya no queda ninguna muestra que pueda no ser representativa. Introduce otros riesgos, que se tratan más abajo.
Calibración: notas justas
La calibración es lo que hace que una scorecard sea fiable. En una sesión de calibración, varios revisores, y cada vez más la IA, evalúan las mismas conversaciones de forma independiente y luego comparan y concilian las diferencias. Así salen a la luz los criterios ambiguos, se alinea la interpretación y se construye el estándar compartido que hace que los agentes acepten sus notas. Sin calibración, una «nota» es solo la opinión de una persona. Con ella, la scorecard se convierte en una medida justa y coherente, que es justamente de lo que se trata.
La mayoría de las guías se quedan ahí, sin decir cómo es una calibración superada. Póngale cifras. Cada mes, de tres a cinco revisores evalúan de forma independiente las mismas seis conversaciones, sin hablar entre ellos, y después miden dos cosas.
Dispersión de notas. La diferencia entre el total más alto y el más bajo en la misma conversación. Un umbral práctico de trabajo es de 10 puntos en una scorecard de 100 puntos. Una diferencia mayor significa que las definiciones de los criterios son ambiguas, no que un revisor se equivoque.
Acuerdo por criterio. Identifique en qué criterios concretos discrepan sus revisores. Casi nunca son los binarios. Son las escalas de juicio con niveles sin definir. Si quiere una medida formal, el kappa de Cohen corrige el acuerdo por azar, y las franjas estándar de Landis y Koch sitúan de 0,41 a 0,60 como moderado, de 0,61 a 0,80 como sustancial y de 0,81 a 1,00 como casi perfecto (resumido aquí). Apunte a 0,61 o más en cualquier criterio con un peso real. Por debajo de 0,41, el criterio mide al revisor más que al agente.
Corrija la scorecard, no al revisor. Cuando la calibración detecta desacuerdo, reescriba la definición del criterio. Pedir a los revisores que se esfuercen más no sobrevive a la siguiente conversación ambigua.
Cómo se vive desde el lado del agente
Las scorecards las diseñan los managers y las viven los agentes, y la distancia entre esas dos miradas es donde los programas de calidad fracasan en silencio. Los agentes de atención al cliente hablan de sus programas en público y con detalle, y los mismos patrones se repiten.
El muestreo parece cuestión de suerte, porque con estos tamaños de muestra en parte lo es. Un agente cuenta que rinde bien en los tipos de conversación que mejor domina, y luego: «I followed my call flow to perfection on my new bookings and yet, they didn’t pull those.» (en esencia: seguí mi guion a la perfección en mis nuevas reservas y aun así no eligieron esas) (r/callcentres) No es paranoia. Es un margen de error de unos 26 puntos vivido desde dentro.
Las muestras desiguales destruyen la comparación. De un hilo sobre QA automatizado: «This means my score might be based on 20 calls and my coworkers is based on 34.» (en esencia: mi nota puede basarse en 20 llamadas y la de mi compañero en 34) (r/callcentres) Si clasifica a los agentes, mantenga constante el tamaño de la muestra.
Un solo hecho incontrolable puede arruinar una media móvil. «My dog barked ( he rarely does) and I got a zero on a call that otherwise would’ve been a perfect 100.» (en esencia: mi perro ladró y saqué un cero en una llamada que, si no, habría sido un 100 perfecto) (r/callcentres) Es el problema de los errores críticos en la media, en la vida real.
Los criterios que ignoran el motivo de contacto se perciben como trabajo inútil. Un agente, al ser evaluado por crear rapport: «I work for an energy retailer, I don’t need to take someone on a journey when they ask to make a payment.» (en esencia: trabajo para una comercializadora de energía, no necesito llevar a nadie de viaje cuando solo quiere hacer un pago) Si su scorecard aplica los mismos criterios a un restablecimiento de contraseña y a la notificación de un fallecimiento, generará rechazo y medirá lo que no es. Use scorecards específicas por canal o por tipo de contacto, o use bien el N/A.
Un error del revisor sin vía de corrección envenena todo el programa. «3 of the 4 things that they said I didn’t ask, I absolutely did.» (en esencia: de las 4 cosas que dijeron que no pregunté, 3 sí las pregunté) (r/callcentres)
La solución aparece en ese mismo hilo, descrita por un analista de QA cuyo programa funciona. Los revisores se envían llamadas entre sí «to make sure we’re being fair and accurate» (para asegurarse de ser justos y precisos), los agentes pueden impugnar cualquier nota y, cuando el equipo de QA se equivoca, «own up to it and award the points back» (lo reconocen y devuelven los puntos). Eso es calibración más un proceso de apelación, y es la diferencia entre una scorecard en la que la gente confía y una que la gente simplemente soporta.
Así que incluya la apelación desde el principio. Dé a los agentes la conversación evaluada, el desglose por criterio, un plazo para impugnar y una persona designada que decide. Siga su tasa de notas revocadas. Si está cerca de cero, probablemente los agentes han dejado de molestarse. Si supera aproximadamente el 10%, su scorecard es ambigua.
Scorecard de QA frente a rúbrica de QA
Los términos se usan a menudo como sinónimos. Una rúbrica de QA suele referirse a la guía de evaluación detallada, qué merece cada nota en cada criterio, mientras que la scorecard de QA es el instrumento estructurado en su conjunto: los criterios, los pesos y la evaluación. En la práctica, una buena scorecard incluye la guía a nivel de rúbrica para que los revisores y la IA interpreten cada criterio de la misma forma.
Errores comunes en una scorecard de QA
- Demasiados criterios. Una scorecard sobrecargada diluye la señal que importa y ralentiza la evaluación.
- Redacción ambigua. Los criterios subjetivos producen notas incoherentes y el rechazo de los agentes.
- Sin ponderación. Tratar todos los criterios por igual oculta lo que de verdad importa.
- Sin errores críticos. Dejar pasar un incumplimiento normativo porque el resto obtuvo buena nota.
- Crearla y olvidarla. Una scorecard que nunca se actualiza se desalinea del negocio.
Para saber qué no hacer, consulte la checklist de errores a evitar en las scorecards de QA.
Evaluación manual frente a automatizada
Una scorecard solo es útil si puede aplicarla. Evaluada a mano, incluso una gran scorecard llega a menos del 5% de las conversaciones. Evaluada con IA, como con las scorecards de Kaizo, la misma scorecard se aplica al 100%, de forma coherente, y libera a los revisores para la calibración y el coaching.
| Evaluación manual | Evaluación automatizada | |
|---|---|---|
| Cobertura | Menos del 5% de las conversaciones | 100% de las conversaciones |
| Coherencia | Varía según el revisor y el día | Un único estándar coherente |
| Esfuerzo | Horas de evaluación cada semana | Redirigido al coaching |
Vea cómo el QA automatizado aplica su scorecard a cada conversación, y cómo el coaching con IA convierte los resultados en desarrollo de los agentes.
100% de las conversaciones evaluadas con su scorecard, frente a la media manual de menos del 5%
100% del QA automatizado en UiPath, con +8% de nota de calidad por trimestre
75% menos de tiempo de preparación del coaching en EverHelp, en 16 dominios
Scorecards de QA para conversaciones atendidas por IA
A medida que los agentes de IA empiezan a atender conversaciones, la misma scorecard debe evaluarlos también, con un único estándar, para poder comparar directamente la calidad humana y la de la IA. Una scorecard bien construida, aplicada al 100% de las conversaciones, se convierte en el nivel de calidad compartido de toda su operación, humanos e IA por igual.
Versionar su scorecard
Su scorecard cambiará, y cuando lo haga romperá su propia línea de tendencia. Las notas de antes y de después no son comparables, y casi nadie le avisa de ello.
Bastan tres prácticas. Versione la scorecard y marque cada evaluación con la versión utilizada. Nunca cambie los pesos a mitad de trimestre. Cuando la cambie, vuelva a evaluar 20 conversaciones archivadas con la scorecard antigua y con la nueva para conocer el tamaño del cambio, y anote el cambio en cada gráfico que lo atraviese.
Revise la scorecard dos veces al año frente a sus motivos de escalamiento actuales. Los criterios que tenían sentido hace dos generaciones de producto suelen sobrevivir mucho más de lo que deberían.
En resumen
La scorecard de QA es la pieza más importante de un programa de calidad. Manténgala enfocada, pondérela según el impacto, defina los errores críticos, calíbrela y actualícela a medida que cambia su negocio. Después, aplíquela al 100% de las conversaciones con automatización para que el estándar que tanto le costó definir llegue de verdad a cada interacción, no solo a una muestra. Así es como una scorecard deja de ser una checklist y se convierte en el motor de una calidad coherente.
Preguntas frecuentes
¿Cómo se calcula una nota de QA?
Sume los puntos obtenidos y divídalos por los puntos que de verdad estaban disponibles en esa conversación, no por el total nominal de la scorecard. Si un criterio de 20 puntos no aplicaba, el denominador es 80, no 100. Un agente con 68 puntos obtiene un 85% con el método correcto y un 68% con el incorrecto.
¿Cuántas conversaciones debo revisar por agente?
De cinco a diez por agente al mes es la recomendación habitual, y basta para encontrar comportamientos en los que hacer coaching. No basta para clasificar a los agentes entre sí ni para vincular la remuneración, porque con cinco revisiones el margen de error ronda los 26 puntos porcentuales. Si necesita comparaciones individuales, aumente bastante la muestra o evalúe todo de forma automática.
¿Cómo mejoro una nota de QA baja?
Mire los datos por criterio, no el total. Un 72% causado por olvidar siempre la verificación se corrige en diez minutos. El mismo 72% repartido por igual entre todos los criterios es un problema completamente distinto. Si no puede ver qué criterios bajan la nota, lo primero que debe corregir son sus reportes.
¿Cómo creo una checklist de QA?
Parta de sus últimos 50 escalamientos y reembolsos, etiquete cada uno con el comportamiento que lo habría evitado y deje que la frecuencia fije sus criterios. Limite la lista a 20 elementos y escriba una definición de una frase para cada nivel de nota.
¿Qué diferencia hay entre una scorecard de QA y una rúbrica de QA?
La rúbrica es la guía de evaluación detallada de cada criterio; la scorecard es el instrumento global de criterios, pesos y evaluación. Las buenas scorecards incluyen guía a nivel de rúbrica.
¿Cuántos criterios debe tener una scorecard de QA?
Menos de los que cree. Céntrese en los criterios que predicen los resultados para el cliente. Una scorecard sobrecargada diluye la señal y ralentiza la evaluación.
¿Se puede evaluar una scorecard de QA de forma automática?
Sí. El QA automatizado aplica su scorecard al 100% de las conversaciones con IA, de forma coherente, mientras las personas se encargan de la calibración y el coaching.
¿Necesita scorecards distintas para chat, correo electrónico y voz?
Normalmente sí, al menos con pesos distintos. Las categorías básicas se mantienen, pero criterios como el ritmo de respuesta o el control de la llamada son propios de cada canal.
Fuentes
- Zendesk, fórmula de la nota de calidad interna
- Balto, ponderaciones por sección
- VereQuest, scorecard de comportamientos de 100 puntos y tratamiento del N/A
- Five9, ponderación por resultados y frecuencia de calibración
- MaestroQA, categorías de errores críticos
- Call Centre Helper, tamaño de la muestra
- HiveDesk, tamaño de la muestra según antigüedad
- OttoQA, evaluaciones por agente (afirmación de proveedor, sin fuente)
- C2Perform, parámetros de confianza
- Landis y Koch, franjas de interpretación del kappa
Las cifras de margen de error de esta página están calculadas, no tomadas de una fuente, y se indican como tales donde aparecen. Las citas de profesionales proceden de hilos públicos de r/callcentres, enlazados en el texto.
Lecturas relacionadas
- 5 plantillas gratuitas de scorecard de QA (en inglés)
- Errores críticos en QA (en inglés)
- Cómo redactar una rúbrica de QA que una IA pueda evaluar (en inglés)
- Calibración de QA: sesiones que eliminan el sesgo en la evaluación (en inglés)
Aplique su scorecard de QA al 100% de las conversaciones
Reserve una demo de 30 minutos y vea cómo Kaizo evalúa automáticamente cada conversación con su scorecard y convierte los resultados en coaching.





