
KI-Qualitätssicherung im Kundenservice ist der Einsatz von KI, um Kundenservice-Konversationen anhand Ihrer Qualitäts-Scorecard zu bewerten, statt dass Reviewer eine kleine Stichprobe von Hand prüfen. Es geht um Konversationen im Kundenservice, nicht um Softwaretests. Sie kann jede Konversation abdecken, während in einer Umfrage von Call Centre Helper (2016) 68 % der Contact Center 2 % oder weniger von Hand bewerteten, und ein gutes System zeigt hinter jedem Score den Beleg im Transkript.
Kurz gesagt
- Automatisierte Qualitätssicherung bewertet Konversationen mit KI anhand Ihrer eigenen Scorecard.
- Sie deckt jede Konversation ab, während manuelle Stichproben nur einen kleinen Ausschnitt erreichen.
- Jeder Score sollte auf die Zeilen im Transkript verweisen, die ihn begründen, damit ein Reviewer ihn prüfen kann.
- Kalibrierung und menschliche Prüfung machen KI-Scores vertrauenswürdig.
- Führen Sie sie in einem Team ein und erhöhen Sie dann den Automatisierungsgrad, sobald sich die Scores bewährt haben.
Was ist KI-Qualitätssicherung im Kundenservice?
Auto QA bewertet jede Interaktion, markiert die, die Aufmerksamkeit brauchen, und macht aus den Ergebnissen Coaching pro Agent. Eine kurze Definition finden Sie unter Was ist Auto QA?.
Im Kundenservice oder Contact Center bedeutet „QA“, die Qualität von Konversationen zu bewerten: Wurde dem Kunden tatsächlich geholfen, wurden die Richtlinien eingehalten, war der Ton empathisch, wurde das Anliegen beim ersten Kontakt gelöst? Klassisch liest eine QA-Verantwortliche oder Teamleitung pro Agent und Woche eine Handvoll Tickets und bewertet sie von Hand nach einem Bewertungsschema. Automatisierte QA überträgt diese Bewertung an eine KI-Engine: Jede Konversation wird bewertet, einheitlich und in großem Umfang, und die Zeit der Manager verlagert sich vom Bewerten zum Verbessern.
Ist KI-Qualitätssicherung dasselbe wie automatisierte QA?
Im Kundenservice weitgehend ja. KI-Qualitätssicherung ist automatisierte QA, bei der ein Sprachmodell jede Konversation liest und nach Ihren Kriterien bewertet, statt dass Keyword-Regeln oder Stimmungsmarker einen groben ersten Durchgang machen.
In der Praxis läuft KI-Qualitätssicherung in zwei Modi, und Kaizo benennt sie getrennt. AutoPilot bewertet jede Konversation selbstständig, sobald sie gelöst ist, mit einem Kommentar, der jeden Score erklärt. Auto QA beschleunigt eine menschliche Prüfung: Es füllt die automatisierten Kriterien wie Grammatik, Rechtschreibung und Einhaltung von Abläufen vorab aus und entwirft Feedback, das der Reviewer bearbeitet und freigibt. Die meisten Teams nutzen beide Modi: den ersten für die Abdeckung, den zweiten für die Konversationen, die sich ein Mensch ansehen muss.
Die Entwicklung der QA: von der Stichprobe zur autonomen Bewertung
Die Qualitätssicherung im Kundenservice hat drei klar unterscheidbare Phasen durchlaufen. Wer sie kennt, versteht, warum automatisierte QA nicht einfach eine schnellere Version des alten Wegs ist, sondern ein grundlegend anderes Modell.
- Phase 1, manuelle Stichproben. QA lebte in Tabellen. Eine Managerin zog ein paar Tickets pro Agent, bewertete sie nach einem Schema und hoffte, die Stichprobe sei repräsentativ. Das war sie selten, und die Scores waren subjektiv.
- Phase 2, QA-Software. Scorecards wurden digital. Kalibrierung, Dashboards und Workflows machten die Bewertung einheitlicher und nachvollziehbarer, aber ein Mensch bewertete weiterhin nur eine kleine Stichprobe. Die Obergrenze der Abdeckung blieb gleich.
- Phase 3, KI-gestützt und dann autonom. KI bewertet heute jede Konversation, und Menschen rücken auf zu Kalibrierung, Coaching und Entscheidungen. Ein Dauerbetrieb bewertet fortlaufend, ohne dass jemand Prüfungen anstößt. Die Abdeckung springt von einer Stichprobe auf alles.
Jetzt beginnt eine vierte Verschiebung: KI bewertet Konversationen nicht nur, sondern führt sie auch selbst.
Warum manuelle QA im großen Maßstab scheitert
Manuelle QA scheitert im großen Maßstab, weil ein Reviewer pro Agent und Woche nur wenige Tickets bewerten kann. Die Abdeckung sinkt auf wenige Prozent, während Verzerrung, Verzögerung und der Zeitaufwand erfahrener Leute mit der Teamgröße wachsen. Manuelle QA funktioniert gut, solange ein Team klein ist. Sie bricht in dem Moment zusammen, in dem das Volumen wächst, und zwar auf vier vorhersehbare Arten:
- Die Abdeckung bricht ein. Ein Reviewer schafft realistisch nur wenige Tickets pro Agent und Woche. Über ein großes Team ist das ein kleiner Bruchteil aller Konversationen. Jede Entscheidung über Coaching, Compliance und Leistung beruht dann auf einer nicht repräsentativen Stichprobe.
- Verzerrung schleicht sich ein. Zwei Reviewer bewerten dieselbe Konversation unterschiedlich, und derselbe Reviewer bewertet am Montag anders als am Freitag. Agents verlieren das Vertrauen in Scores, die sie als subjektiv empfinden.
- Sie ist reaktiv. Weil so wenig geprüft wird, zeigen sich systematische Probleme erst, nachdem sich Kunden beschwert haben, nicht vorher.
- Sie bindet erfahrene Leute. QA-Verantwortliche und Teamleitungen verbringen oft viele Stunden pro Woche mit Prüfungen und noch mehr Zeit mit der Vorbereitung von Coaching, Zeit, die nicht skaliert und die Qualität nicht direkt verbessert.
Die versteckten Kosten sind erheblich. In einer großen Supportorganisation können die Vollkosten für manuelle Reviewer plus die Reporting-Zeit drumherum schnell zusammenkommen, nur um einen Bruchteil der Arbeit zu prüfen. Automatisierte QA setzt genau an dieser Rechnung an.
Automatisierte QA vs. manuelle QA
Manuelle QA bewertet eine kleine Stichprobe von Hand, mit Ergebnissen, die je nach Reviewer schwanken; automatisierte QA bewertet jede Konversation nach einem einheitlichen Standard und erstellt aus den Ergebnissen Coaching. Das Kernproblem, das automatisierte QA löst, ist die Stichprobe: Jede Konversation zu bewerten macht QA nicht nur schneller, es verändert, was QA Ihnen sagen kann. Einen ausführlicheren Vergleich finden Sie unter manuelle QA vs. Auto QA.
| Manuelle QA | Automatisierte QA | |
|---|---|---|
| Abdeckung | Eine kleine Stichprobe der Konversationen | Jede Konversation |
| Einheitlichkeit | Unterschiede von Reviewer zu Reviewer | Ein einheitlicher Standard |
| Geschwindigkeit | Stunden manueller Prüfung pro Woche | Fortlaufend und automatisch bewertet |
| Grundlage fürs Coaching | Von Hand vorbereitet | Automatisch aus echten Daten erzeugt |
| Sichtbarkeit | Einzelfälle aus wenigen Tickets | Echter Qualitätstrend für das ganze Team |
| Skaliert durch | Mehr Reviewer einstellen | Mehr Automatisierung |
Das Wichtigste: Manuelle QA beantwortet die Frage „Wie liefen diese fünf Tickets?“ Automatisierte QA beantwortet „Wie steht das ganze Team da, bei jeder Konversation, jetzt gerade?“
Wie automatisierte QA funktioniert
Automatisierte QA arbeitet in vier Schritten: Sie holt jede Konversation aus Ihrem Helpdesk, wendet die gewichtete Scorecard an, die Sie festlegen, bewertet jede Konversation mit einer Erklärung und markiert die, die einen Menschen brauchen, und macht aus den Ergebnissen Coaching für jeden Agent. Die folgenden Schritte zeigen, was in jeder Phase passiert.
- Jede Konversation einlesen. Die Plattform verbindet sich mit Ihrem Helpdesk und holt Konversationen aus allen Kanälen, Chat, E-Mail, Tickets und Messaging, sodass nichts außen vor bleibt.
- Ihre Scorecard festlegen. Sie erstellen einmal eine eigene, gewichtete Scorecard mit den Kriterien, die für Ihr Team eine gute Konversation ausmachen, oder Sie starten mit einer Vorlage und passen sie an.
- Die KI bewertet automatisch 100 %. Eine KI-Engine bewertet jede Konversation anhand der Scorecard und markiert die, die Aufmerksamkeit brauchen. Mit einem Dauerbetrieb wie Kaizo Kaizo AutoPilot läuft das fortlaufend im Hintergrund, ohne dass jemand Prüfungen anstößt.
- Coaching entsteht pro Agent. Aus den Ergebnissen wird Coaching für jeden einzelnen Agent. Teamleitungen coachen auf Basis von Erkenntnissen, statt ihre Woche mit der Vorbereitung zu verbringen, und die Verbesserung wird über die Zeit verfolgt.
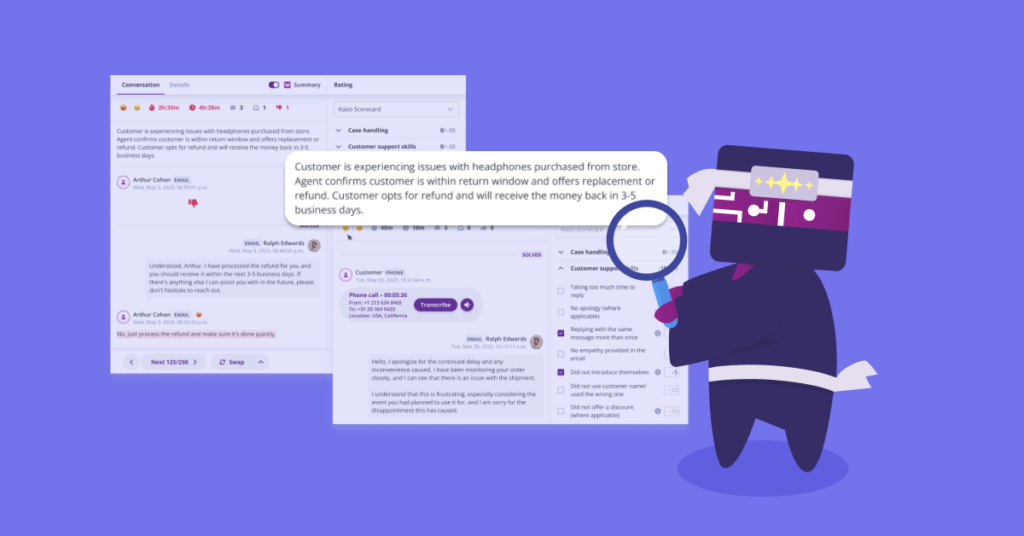
Ein nützlicher Begriff ist hier die Automatisierungsquote der Scorecard: der Anteil der Konversationen, die bewertet werden, ohne dass ein Mensch sie prüft. Teams starten meist mit viel menschlicher Aufsicht und erhöhen diesen Regler, wenn das Vertrauen in die KI wächst. Genau so sollte eine Einführung laufen (mehr dazu weiter unten).
Was automatisierte QA tatsächlich bewertet
Automatisierte QA bewertet dasselbe wie ein guter menschlicher Reviewer: ob das Anliegen korrekt gelöst wurde, ob vorgeschriebene Abläufe und Compliance-Schritte eingehalten wurden, wie klar und empathisch die Kommunikation war und wie effizient die Konversation abgewickelt wurde. Sie legen die Kriterien und ihre Gewichtung fest. Typische Kriterien sind:
- Lösung und Richtigkeit: Wurde das Anliegen des Kunden tatsächlich gelöst, und waren die Informationen korrekt?
- Ablauf und Compliance: Wurden die vorgeschriebenen Schritte, Hinweise oder Verifizierungen eingehalten?
- Kommunikation und Ton: War die Antwort klar, empathisch und markengerecht?
- Effizienz: Wurde die Interaktion ohne unnötiges Hin und Her abgewickelt?
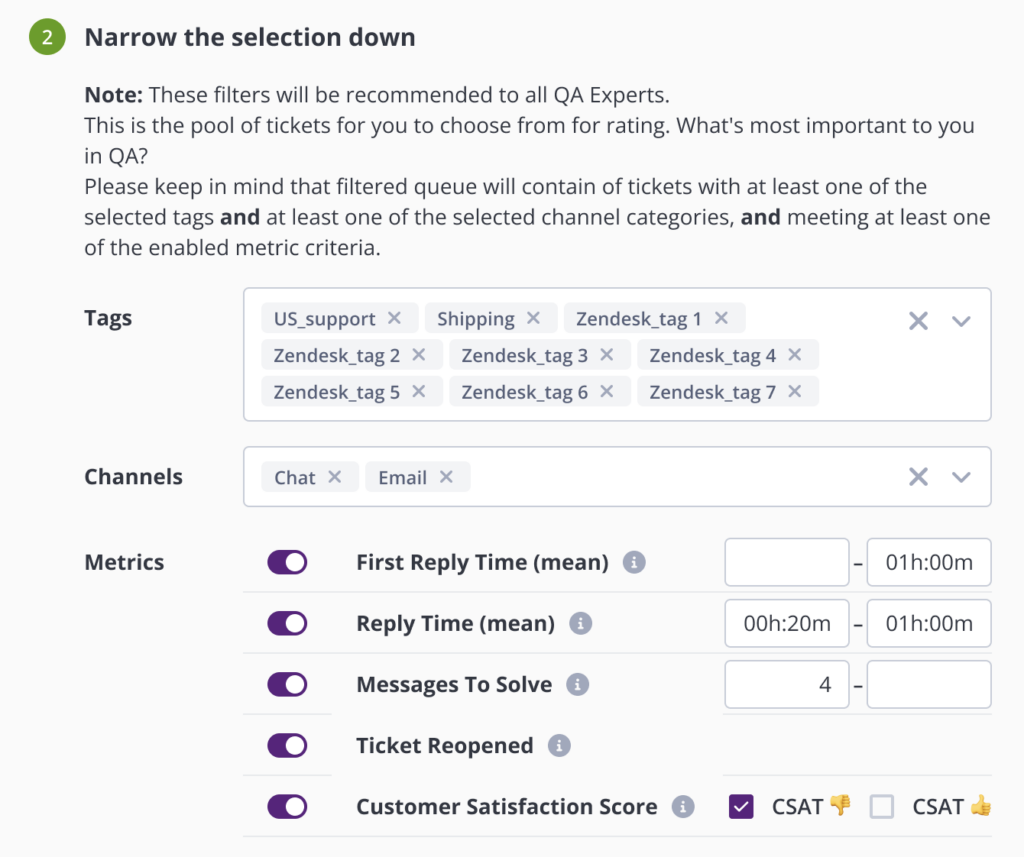
Eine vereinfachte Scorecard könnte diese Kategorien so gewichten:
| Kategorie | Beispielkriterium | Gewichtung |
|---|---|---|
| Lösung | Wurde das Anliegen vollständig gelöst? | 35 % |
| Compliance | Wurden vorgeschriebene Schritte und Hinweise eingehalten? | 25 % |
| Kommunikation | Klarer, empathischer, markengerechter Ton | 25 % |
| Effizienz | Ohne unnötiges Hin und Her abgewickelt | 15 % |
Die Gewichtung sollte widerspiegeln, was Ihrem Team wirklich wichtig ist. Ein stark regulierter Fintech-Anbieter gewichtet Abläufe deutlich höher als ein SaaS-Unternehmen in der Wachstumsphase, das auf Tempo und Ton setzt.
Die fortschrittlichste automatisierte QA bewertet nicht nur, was gesagt wurde, sondern prüft, was getan wurde. Statt nur Keywords oder Stimmung abzugleichen, kann die Engine verifizieren, ob die zugesagte Aktion tatsächlich stattgefunden hat. Dieser Unterschied, Ergebnisse statt Formulierungen zu bewerten, trennt wirklich nützliche automatisierte QA von oberflächlicher Bewertung.
Die Vorteile automatisierter QA und der ROI
- Vollständige Abdeckung. Qualität wird im ganzen Team gemessen, sodass nichts Systematisches durchrutscht.
- Einheitlichkeit und weniger Verzerrung. Ein Standard, der bei jeder Konversation gleich angewendet wird, beseitigt Unterschiede zwischen Reviewern und stellt das Vertrauen der Agents in die Scores wieder her.
- Coaching, das sich selbst organisiert. Automatisch erzeugtes Coaching senkt die Vorbereitungszeit deutlich und verknüpft Coaching mit messbarer Wirkung.
- Niedrigere QA-Kosten pro Konversation. Teams skalieren Qualität, ohne die Zahl der Reviewer zu erhöhen, und genau daher kommt der ROI.
Der Business Case ist für Budgetverantwortliche einfach: Wenn manuelle QA mit einem Team von Reviewern nur einen kleinen Ausschnitt der Konversationen abdeckt, können Sie mit automatisierter Bewertung alle abdecken und den Großteil der Reviewer-Zeit umschichten. Diese Ergebnisse berichten Teams aus dem Betrieb:
50 % weniger Zeit für QA bei SteelSeries, dank KI-Zusammenfassungen
68 % der Contact Center bewerteten 2 % ihrer Interaktionen oder weniger von Hand, in einer Umfrage unter Contact Centern (2016)
Die Einsparungen beginnen, wenn die Abdeckung von einer Stichprobe auf alles springt, denn ab diesem Punkt verlagert sich die Reviewer-Zeit vom Bewerten zum Coaching. Der Beitrag zum ROI von Auto QA (auf Englisch) zeigt, wie Sie ihn für Ihr eigenes Team beziffern.
Wie automatisierte QA in der Praxis aussieht
In der Praxis bedeutet automatisierte QA, dass das Team aufhört, Stichproben zu bewerten, und anfängt, auf Basis vollständiger Daten zu handeln. Ein echter Einsatz: SteelSeries, ein Supportteam von 30 Personen mit langen, technischen Tickets (Kundenstory), hat die Zeit für QA mit KI-Zusammenfassungen halbiert und setzt die Ergebnisse über Coaching-Karten und Scorecards um.
Das Muster ist klar: Die Abdeckung geht von einer Stichprobe auf alles, die Zeit erfahrener Leute verlagert sich von der Kontrolle zur Verbesserung, und die Qualität steigt, weil Coaching endlich auf dem vollständigen Bild beruht statt auf einer Handvoll Tickets. Und was nicht passiert: Das QA-Team verschwindet nicht. Seine Arbeit verändert sich. Reviewer werden zu Kalibrierern und Coaches, den höherwertigen Rollen, für die die manuelle Bewertung nie Zeit ließ.
Sehen Sie es in einer Live-Demo. Kaizo bewertet 100 % Ihrer Supportkonversationen anhand Ihrer eigenen Scorecard, zeigt den Beleg hinter jedem Score und macht aus den Ergebnissen Coaching. Sprechen wir.
Nachvollziehbare Scores: so prüfen Sie, warum die KI eine Konversation so bewertet hat
Ein nachvollziehbarer Score der automatisierten QA verknüpft jedes Kriterienergebnis mit den Zeilen im Transkript, die es begründen, und einem kurzen Kommentar in klarer Sprache. Ein Reviewer oder Agent kann die Konversation öffnen, den Beleg lesen und den Score in weniger als einer Minute bestätigen oder kippen. Ohne diese Verknüpfung ist ein KI-Score eine Meinung, die niemand prüfen kann, und die Agents verlieren das Vertrauen.
In Kaizo trägt jeder Kriterien-Score seine Begründung und verweist auf die Stelle in der Konversation, auf der er beruht, egal ob ein Mensch oder ein KI-Agent die Konversation geführt hat. So kann eine Teamleitung direkt vom Score aus coachen, statt das Ticket erneut zu lesen, und eine QA-Verantwortliche kann einen Streitfall mit Belegen klären. Der Leitfaden zur Nachvollziehbarkeit von QA-Scores (auf Englisch) geht tiefer darauf ein, worauf Sie achten sollten, und der Beitrag So validieren Sie KI-QA-Bewertungen (auf Englisch) zeigt, wie Sie sie an Ihren eigenen Reviewern testen, bevor Sie sich darauf verlassen.
Tools, die die Qualitätssicherung für Supportteams automatisieren
Tools für automatisierte Qualitätssicherung lassen sich in drei Gruppen einteilen: spezialisierte QA-Plattformen wie Kaizo, die jede Konversation nach Ihrer eigenen Scorecard bewerten und das Coaching steuern, QA-Add-ons in einer Helpdesk- oder Contact-Center-Suite und Conversation-Analytics-Tools, die Trends sichtbar machen, ohne nach einem Standard zu bewerten. Welche Gruppe passt, hängt davon ab, wie viel Kontrolle Sie über die Kriterien brauchen.
- Spezialisierte QA-Plattformen gehen bei eigenen Kriterien, Kalibrierung und Coaching am tiefsten. Kaizo verbindet sich nativ mit Zendesk und Salesforce und betreibt QA-Automatisierung bei 100 % der Konversationen.
- Add-ons von Suiten halten alles in einem Vertrag, aber der Qualitätsstandard folgt der Roadmap und dem Helpdesk dieses Anbieters.
- Analytics-Tools beantworten „Was passiert in unseren Konversationen?“ gut, „Wie gut war diese Konversation?“ weniger gut.
Einen direkten Vergleich konkreter Tools finden Sie in unserem Leitfaden zu KI-Tools für die Qualitätssicherung und im Vergleich der QA-Software für den Kundenservice.
Den Business Case für automatisierte QA aufbauen
Der Business Case für automatisierte QA verbindet eine harte Einsparung bei der Reviewer-Zeit mit einem Gewinn bei Qualität und CSAT durch Coaching auf Basis vollständiger Daten, und er muss bei drei Zielgruppen zugleich ankommen: der QA-Leitung, der Support- oder Operations-Leitung und den Teamleitungen. Der stärkste Business Case adressiert alle drei:
- Die QA-Leitung achtet auf Abdeckung und Verzerrung: von einer kleinen Stichprobe zu jeder Konversation und ohne Unterschiede zwischen einzelnen Reviewern.
- Die Support- oder Operations-Leitung achtet auf ROI und Zeit: zurückgewonnene Reviewer-Stunden, schnelleres Reporting und eine Amortisationszeit, die sie vertreten können.
- Teamleitungen achten auf Coaching: weniger Vorbereitung, mehr Zeit mit den Agents und eine Wirkung, die sie tatsächlich sehen.
Verbinden Sie eine harte Kosteneinsparung durch zurückgewonnene Reviewer-Zeit mit einem Gewinn bei Qualität und CSAT durch Coaching auf Basis vollständiger Daten. Legen Sie den Pilot auf ein einzelnes Team an, damit sich der Vorher-nachher-Vergleich leicht messen lässt, und rechnen Sie die zurückgewonnenen Stunden und die Score-Verbesserung dann auf die gesamte Organisation hoch, um das volle Potenzial zu beziffern.
Ist automatisierte QA genau? So können Sie den Scores vertrauen
Die häufigste Frage von QA-Verantwortlichen ist, ob sie einem KI-Score vertrauen können. Die Antwort: Behandeln Sie menschliche Aufsicht als bewusste Gestaltungsentscheidung, nicht als Lücke. Ein vertrauenswürdiges Auto-QA-Programm stützt sich auf eine Hierarchie von Feedback-Signalen:
- Kalibrierungssitzungen gleichen die KI mit den Standards Ihres Teams ab und sind das Signal mit dem höchsten Vertrauen im System.
- Korrekturen durch Reviewer im großen Umfang sorgen dafür, dass jede menschliche Übersteuerung eines Scores die künftige Bewertung verbessert.
- Rate-the-Rater-Prüfungen halten die Bewertung durch Menschen und KI ehrlich.
- Externe Validierung verknüpft QA-Scores mit dem CSAT, sodass Sie bestätigen können, dass höhere Scores mit zufriedeneren Kunden einhergehen und nicht nur mit interner Meinung.
Sie behalten außerdem die Kontrolle. Mit dem Automatisierungsregler entscheiden Sie, wie viel ohne Menschen im Prozess bewertet wird: Sie starten vorsichtig und erhöhen die Autonomie erst, wenn das Vertrauen wächst.
Automatisierte QA einführen
Führen Sie automatisierte QA schrittweise ein: Starten Sie mit einem Pilotteam, das parallel zu Ihrem manuellen Prozess bewertet, schreiben Sie die Scorecard fest, kalibrieren Sie die KI an vertrauenswürdigen menschlichen Scores, erhöhen Sie dann den automatisch bewerteten Anteil, solange die Übereinstimmung hält, und leiten Sie jede Erkenntnis ins Coaching. Eine Umstellung aller Teams auf einen Schlag ist der Punkt, an dem die meisten Einführungen das Vertrauen der Agents verlieren.
- Mit einem Pilotteam starten. Wählen Sie ein Team oder eine Queue, verbinden Sie den Helpdesk und lassen Sie die KI parallel zu Ihrem bestehenden manuellen Prozess bewerten.
- Die Scorecard festschreiben. Übertragen Sie Ihr aktuelles Bewertungsschema in eine gewichtete Scorecard. Das ist auch ein guter Moment, Kriterien zu streichen, die nie wirklich Ergebnisse beeinflusst haben.
- Kalibrieren. Führen Sie Kalibrierungssitzungen durch, in denen Sie KI-Scores mit vertrauenswürdigen menschlichen Scores vergleichen, und justieren Sie, bis sie übereinstimmen.
- Den Automatisierungsregler hochdrehen. Wenn die Kalibrierung hält, erhöhen Sie den Anteil automatisch bewerteter Konversationen und verlagern Reviewer vom Bewerten zum Coaching.
- Den Kreis mit Coaching schließen. Leiten Sie die Erkenntnisse in Coaching für jeden einzelnen Agent und verfolgen Sie die Wirkung nach 30, 60 und 90 Tagen.
Häufige Fehler bei automatisierter QA
- Sie als „manuelle QA plus ein bisschen KI“ behandeln. Eine KI-Hilfe an die Stichprobe anzuflanschen, verfehlt den Zweck. Der Wert liegt in der Abdeckung von 100 %.
- Die Scorecard überladen. Zu viele Kriterien verwässern das Signal. Bewerten Sie, was Kundenergebnisse tatsächlich vorhersagt.
- Die Kalibrierung überspringen. Ohne Kalibrierung vertrauen Teams der KI entweder zu sehr oder zu wenig. Erst die Kalibrierung rechtfertigt einen höheren Automatisierungsgrad.
- Bewerten ohne Coaching. Scores, aus denen kein Coaching wird, ändern kein Verhalten. Schließen Sie den Kreis.
Kennzahlen für automatisierte QA
Sobald Sie alles bewerten, verfolgen Sie fünf Kennzahlen der automatisierten QA: den Trend des Qualitätsscores über das ganze Team, die Automatisierungsquote der Scorecard, die Korrelation zwischen QA-Scores und CSAT, die Wirkung des Coachings pro Agent über die Zeit und die QA-Kosten pro Konversation. Zusammen zeigen sie, ob das Programm genau ist, reifer wird und sich bezahlt macht.
- Trend des Qualitätsscores über das ganze Team, nicht über eine Stichprobe.
- Automatisierungsquote der Scorecard, der Anteil ohne menschliche Bewertung, als Maß für die Reife.
- Korrelation zwischen QA und CSAT, um zu belegen, dass die Scores die echte Kundenerfahrung widerspiegeln.
- Wirkung des Coachings, die Score-Entwicklung pro Agent nach 30, 60 und 90 Tagen.
- QA-Kosten pro Konversation und eingesparte Reviewer-Stunden, für die ROI-Rechnung.
Wie automatisierte QA Ihre zentralen Support-Kennzahlen verbessert
Automatisierte QA verbessert CSAT, die Lösung beim ersten Kontakt, die Einarbeitungszeit der Agents und die Einheitlichkeit über Teams hinweg, weil das Coaching auf jeder Konversation beruht statt auf einer Stichprobe. Sie ist keine Reporting-Übung; sie bewegt die Zahlen, an denen Supportverantwortliche gemessen werden, auf die unten genannten Arten.
- CSAT. Wenn jede Konversation bewertet wird, werden die konkreten Verhaltensweisen sichtbar, die mit Zufriedenheit zusammenhängen. So zielt das Coaching auf das, was den Score wirklich bewegt.
- Lösung beim ersten Kontakt. Vollständige Abdeckung legt die Lücken bei der Lösung offen, die eine kleine Stichprobe übersehen würde, von übersprungenen Schritten bis zu falschen Informationen.
- Einarbeitungszeit der Agents. Neue Agents werden sofort anhand echter Konversationen gecoacht, was den Weg zur vollen Produktivität verkürzt.
- Einheitlichkeit über Teams und Standorte. Ein Standard, der überall gilt, hält die Qualität gleichmäßig über interne Teams, Remote-Agents und BPO-Partner hinweg.
Weil die Scores mit dem CSAT verknüpft sind, können Sie den Zusammenhang zwischen Qualitätsarbeit und Kundenergebnissen belegen, statt ihn nur zu behaupten. Genau diesen Nachweis will die Geschäftsleitung sehen, bevor sie weiter investiert.
Automatisierte QA vs. Conversation Intelligence vs. Speech Analytics
Speech Analytics transkribiert und analysiert Anrufe, Conversation Intelligence macht Trends über alle Konversationen sichtbar, und automatisierte QA bewertet jede Konversation nach Ihrem Qualitätsstandard und treibt das Coaching. Diese drei Begriffe werden oft synonym verwendet, sie meinen aber nicht dasselbe. Wer den Unterschied kennt, kauft das richtige Tool.
- Speech Analytics stammt aus Contact Centern mit Telefonie. Es transkribiert Anrufe und analysiert sie auf Keywords, Stimmung und Gesprächsmuster. Es ist stark bei Telefonie und war in digitalen Kanälen historisch schwächer.
- Conversation Intelligence ist breiter. Es analysiert Konversationen über alle Kanäle, um Trends, Kontaktgründe und Erkenntnisse sichtbar zu machen, und beantwortet die Frage „Was passiert in all unseren Konversationen?“
- Automatisierte QA ist an einen Qualitätsstandard gebunden. Sie bewertet jede Konversation anhand Ihrer Scorecard und treibt das Coaching der Agents, und sie beantwortet „Wie gut war diese Konversation, und wie verbessern wir sie?“
Die drei überschneiden sich, und die stärksten modernen Plattformen verbinden die Bewertung durch automatisierte QA mit Erkenntnissen auf Konversationsebene, sodass Qualitätsdaten und geschäftliche Erkenntnisse aus derselben Quelle kommen. Wenn Ihr Ziel ist, die Qualität der Agents im großen Maßstab zu messen und zu verbessern, ist automatisierte QA die Kategorie, an der Sie sich orientieren sollten.
Automatisierte QA nach Teamtyp
Automatisierte QA zahlt sich je nach Teamtyp unterschiedlich aus: BPOs halten damit viele Auftraggeber an einem Standard, schnell wachsende SaaS-Teams halten die Qualität stabil, während sie schnell einstellen, regulierte Teams erreichen Compliance-Abdeckung bei jeder Interaktion, und E-Commerce-Teams schützen den CSAT in saisonalen Spitzen. Der Wert einer Abdeckung von 100 % zeigt sich so:
- BPOs und Outsourcer. Standardisieren Sie die Qualität über viele Auftraggeber hinweg mit einheitlichen Bewertungen, und belegen Sie die Einhaltung der SLAs mit Nachweisen aus jeder Konversation statt aus einer Stichprobe.
- Schnell wachsender SaaS-Support. Halten Sie die Qualität stabil, während die Belegschaft schnell wächst, und verkürzen Sie die Einarbeitung neuer Agents, indem Sie vom ersten Tag an mit echten Konversationen coachen.
- Fintech und regulierte Branchen. Erreichen Sie Compliance-Abdeckung bei jeder Interaktion statt bei einer Stichprobe, mit einem einheitlichen, prüfbaren Standard für jede Konversation.
- E-Commerce und Handel. Schützen Sie den CSAT bei saisonalen Volumenspitzen, wenn die Abdeckung manueller QA unter der Spitzenlast sonst einbrechen würde.
Woran Sie erkennen, dass Ihr Team bereit für automatisierte QA ist
Ihr Team ist bereit für automatisierte QA, wenn die manuelle Prüfung nur eine kleine, nicht repräsentative Stichprobe erreicht, Agents die Scores als subjektiv anfechten, Teamleitungen jede Woche Stunden mit Bewerten verbringen oder KI bereits einen Teil Ihrer Konversationen beantwortet. Wenn mehrere der folgenden Anzeichen zutreffen, ist manuelle QA bereits der Engpass:
- Ihre Reviewer erreichen nur einen kleinen Prozentsatz der Konversationen, und Sie vermuten, dass die Stichprobe nicht repräsentativ ist.
- Agents halten die Scores für subjektiv oder für uneinheitlich zwischen den Reviewern.
- Ihre QA-Verantwortlichen oder Teamleitungen verbringen jede Woche Stunden damit, von Hand zu bewerten und Coaching vorzubereiten.
- Sie bauen Personal auf, und die QA kommt ohne zusätzliche Reviewer nicht mehr hinterher.
- Sie arbeiten über mehrere Teams, Standorte oder BPO-Partner hinweg und tun sich schwer, einen einheitlichen Standard anzuwenden.
- KI übernimmt bereits einen Teil Ihrer Konversationen, und Sie haben keinen einheitlichen Weg, diese zu bewerten.
Wenn drei oder mehr davon auf Sie zutreffen, ist manuelle QA bereits der Engpass, und die Automatisierung ist der Weg daran vorbei.
Wann automatisierte QA nicht das Richtige für Sie ist
Automatisierte QA lohnt sich nicht für jedes Team. Wenn Sie eine Handvoll Tickets pro Woche bearbeiten, ist eine Teamleitung, die sie selbst liest, günstiger und genauso gut. Wenn Sie noch keine schriftliche Scorecard haben, automatisieren Sie nichts, bevor Sie sich darauf geeinigt haben, wie „gut“ aussieht, denn eine KI wendet Ihren Standard an und kann keinen erfinden.
Sie ist auch nicht die richtige erste Anschaffung, wenn Ihr Hauptbedarf die Live-Steuerung von Anrufen ist (Mithören, Flüstern, Aufschalten), denn das ist eine Telefoniefunktion, oder die Einsatzplanung, denn dafür gibt es WFM-Tools. Und wenn Ihr Helpdesk weder Zendesk noch Salesforce ist, klären Sie die Integrationsmöglichkeiten mit uns, bevor Sie eine Einführung rund um Kaizo planen.
Worauf Sie bei einem Tool für automatisierte QA achten sollten
Achten Sie bei einem Tool für automatisierte QA auf fünf Dinge: echte Abdeckung von 100 % in einem Dauerbetrieb, eigene gewichtete Scorecards, Scores, die ihre Belege zeigen, automatisches Coaching pro Agent und eine schnelle Anbindung an den Helpdesk, den Sie bereits nutzen. Ein Tool, das nur KI zu einer manuellen Stichprobe hinzufügt oder verbirgt, warum es eine Konversation so bewertet hat, wird das Vertrauen Ihres Teams nicht gewinnen.
- Echte Abdeckung von 100 % mit einem Dauerbetrieb, nicht eine KI-Erweiterung für manuelle Stichproben.
- Eigene, gewichtete Scorecards, die abbilden, wie Ihr Team Qualität definiert.
- Automatisches Coaching pro Agent, dessen Wirkung über die Zeit verfolgt wird.
- Plattformunabhängige Integrationen, damit das Tool auf Ihrem bestehenden Stack aufsetzt (Zendesk, Salesforce und andere), statt Sie zu binden.
- Schneller Nutzen: in Tagen live statt monatelanger Projekte.
Kaizo ist genau nach diesen Prinzipien gebaut. Sehen Sie, wie Kaizos automatisierte QA funktioniert, entdecken Sie KI-Coaching oder lesen Sie, wie Software für automatisierte QA im Support die Prüfungen beschleunigt, die Sie behalten.
Automatisierte QA und KI-Agenten
Automatisierte QA kann Konversationen von KI-Agenten nach derselben Scorecard bewerten wie die von Menschen, und das wird wichtiger, je mehr Volumen KI übernimmt. Kaizo tut das heute für Konversationen, die die KI-Agenten von Zendesk führen, direkt neben jeder Konversation von Menschen im selben Helpdesk.
Hier wird automatisierte QA strategisch statt nur operativ: Dieselbe Scorecard und dieselbe Engine können Konversationen von Menschen und KI nebeneinander bewerten, nach einem Standard. Für Teams, in denen KI bereits einen nennenswerten Teil des Volumens übernimmt, wird das schnell zum entscheidenden Faktor.
Es gibt einen zweiten Grund, warum das wichtig ist. Wenn KI eine Konversation schlecht führt, müssen Sie es wissen, bevor der Kunde abwandert, nicht danach. Automatisierte QA, die 100 % der Interaktionen von KI und Menschen abdeckt, wird zum Frühwarnsystem für KI-Qualität: Sie erkennt Rückschritte in dem Moment, in dem ein automatisierter Ablauf falsche Antworten gibt oder Sonderfälle übersieht. Ein Stichprobenansatz kann das nicht, weil die fehlerhaften Konversationen statistisch wahrscheinlich nicht in der Stichprobe landen. Je stärker sich der Mix aus Menschen und KI verschiebt, desto stärker wird das Argument für vollständige Abdeckung.
Starten Sie automatisierte QA mit einem Team
Starten Sie KI-Qualitätssicherung mit einem Team, kalibrieren Sie sie an Ihren Reviewern und skalieren Sie dann. Automatisierte Qualitätssicherung ist der Wechsel davon, einen Bruchteil Ihrer Kundenkonversationen zu kontrollieren, hin dazu, alle zu verstehen. Sie ersetzt eine verzerrte Stichprobe durch vollständige Abdeckung, die Subjektivität der Reviewer durch einen einheitlichen Standard und von Hand vorbereitetes Coaching durch automatisch erzeugte Erkenntnisse. Die Teams, die am meisten davon haben, behandeln sie als Programm, nicht als Funktion: Sie schreiben eine fokussierte Scorecard fest, kalibrieren sorgfältig, erhöhen die Automatisierung mit wachsendem Vertrauen und leiten jede Erkenntnis in Coaching, dessen Wirkung sie messen können.
Gewinnen werden in den nächsten Jahren die Organisationen, die Qualität über Konversationen von Menschen und KI hinweg messen und verbessern können, nach einem Standard und ohne zusätzliches Personal. Genau das ermöglicht automatisierte QA, und deshalb ist sie vom netten Extra zum Rückgrat moderner Supportqualität geworden. Um sie mit einer realistischen Scorecard und Beispielkonversationen zu sehen, buchen Sie einen Termin für eine Live-Demo.
Weiterlesen
- Manuelle QA vs. Auto QA: Kosten, Abdeckung und Genauigkeit im Vergleich
- Der ROI von Auto QA: so bauen Sie den Business Case auf (auf Englisch)
- 7 Auto-QA-Fehler, die das Vertrauen der Agents zerstören (auf Englisch)
- Wie genau ist KI-QA?
- Falsch-Positive in der automatisierten QA (auf Englisch)
- Auto-Fail-Kriterien: wann ein Fehler den Score auf null setzen sollte (auf Englisch)
Häufig gestellte Fragen
Wie lange dauert die Einrichtung automatisierter QA?
Mit einer modernen Plattform kann die Bewertung wenige Tage nach der Anbindung Ihres Helpdesks beginnen. In den Wochen danach kalibrieren Sie: Sie vergleichen KI-Scores mit Ihren besten Reviewern, passen Kriterien an, die abweichen, und erhöhen den Anteil automatisch bewerteter Konversationen, solange die Übereinstimmung hält. Kaizo verbindet sich nativ mit Zendesk und Salesforce, es muss also vorher kein eigener Connector gebaut werden.
Welche Kanäle kann automatisierte QA bewerten?
Die meisten Plattformen bewerten die schriftlichen Konversationen in Ihrem Helpdesk, also Chat, E-Mail, Tickets und Messaging, viele auch transkribierte Anrufe. Kaizo bewertet Tickets, Chats und Anrufe in Zendesk sowie Service-Cloud-Konversationen in Salesforce. Wenn Anrufe den Großteil Ihres Volumens ausmachen, prüfen Sie vor dem Kauf, wie ein Tool Sprache transkribiert und bewertet, denn hier unterscheiden sich die Tools am stärksten.
Ersetzt automatisierte QA die QA-Verantwortlichen?
Nein. Sie nimmt die manuelle Bewertung ab, sodass QA-Verantwortliche und Teamleitungen ihre Zeit für Kalibrierung, Coaching und Verbesserung nutzen, die Arbeit, die Qualität wirklich hebt. In der Praxis verschiebt sich ihre Rolle vom Lesen von Tickets dahin, zu prüfen, ob die KI den Standard richtig anwendet, Streitfälle mit Belegen zu klären und Muster in Coaching zu übersetzen. Das Team bleibt meist gleich groß, seine Arbeit verändert sich.
Kann automatisierte QA KI-Agenten und Chatbots bewerten?
Ja. Automatisierte QA kann Konversationen von Chatbots und KI-Agenten nach derselben Scorecard bewerten wie die von Menschen, ergänzt um Prüfungen, die ein Bot braucht, etwa sachliche Richtigkeit, Einhaltung von Richtlinien und korrekte Eskalation. Kaizo bewertet Konversationen von Menschen und KI-Agenten nebeneinander, auch die der KI-Agenten von Zendesk, was wichtiger wird, je größer der Anteil der KI an Ihrem Volumen ist.
Was kostet automatisierte QA?
Die meisten Tools rechnen pro Seat oder pro Helpdesk-Seat ab, manche berechnen Transkription oder KI-Bewertung zusätzlich. Kaizo rechnet pro Seat in drei Plänen ab (Insight, Intelligence und Enterprise), aufgeführt auf der Preisseite, mit einem Angebot je nach Teamgröße. Vergleichen Sie die Kosten mit den Vollkosten der Reviewer-Stunden, die frei werden, nicht nur mit dem alten QA-Tool.
Kann automatisierte QA mehrere Sprachen verarbeiten?
Ja, moderne Plattformen bewerten Konversationen in vielen Sprachen nach einer Scorecard, was für globale Teams und BPOs mit Support in mehreren Regionen wichtig ist. Kaizo liest Konversationen über Kanäle, Teams und Sprachen hinweg. Testen Sie vor der Einführung die Bewertung an einer Stichprobe in jeder Ihrer Hauptsprachen, denn die Genauigkeit kann je nach Sprache und je nach Klarheit Ihrer Kriterien schwanken.






